 kayetana
Modelos que hablan tu idioma.
Algunas tareas se repiten cada día. El fine-tuning enseña a un modelo cómo las resuelve tu equipo, con tus propios ejemplos de conversación o textos etiquetados, directamente en tu servidor.
Lo que puedes entrenar.
Tu propio modelo de chat
Haz fine-tuning de qwen3:4b-instruct con LoRA sobre tus ejemplos de conversación. El resultado es tu propio modelo, «ft-name».
Tu propio clasificador
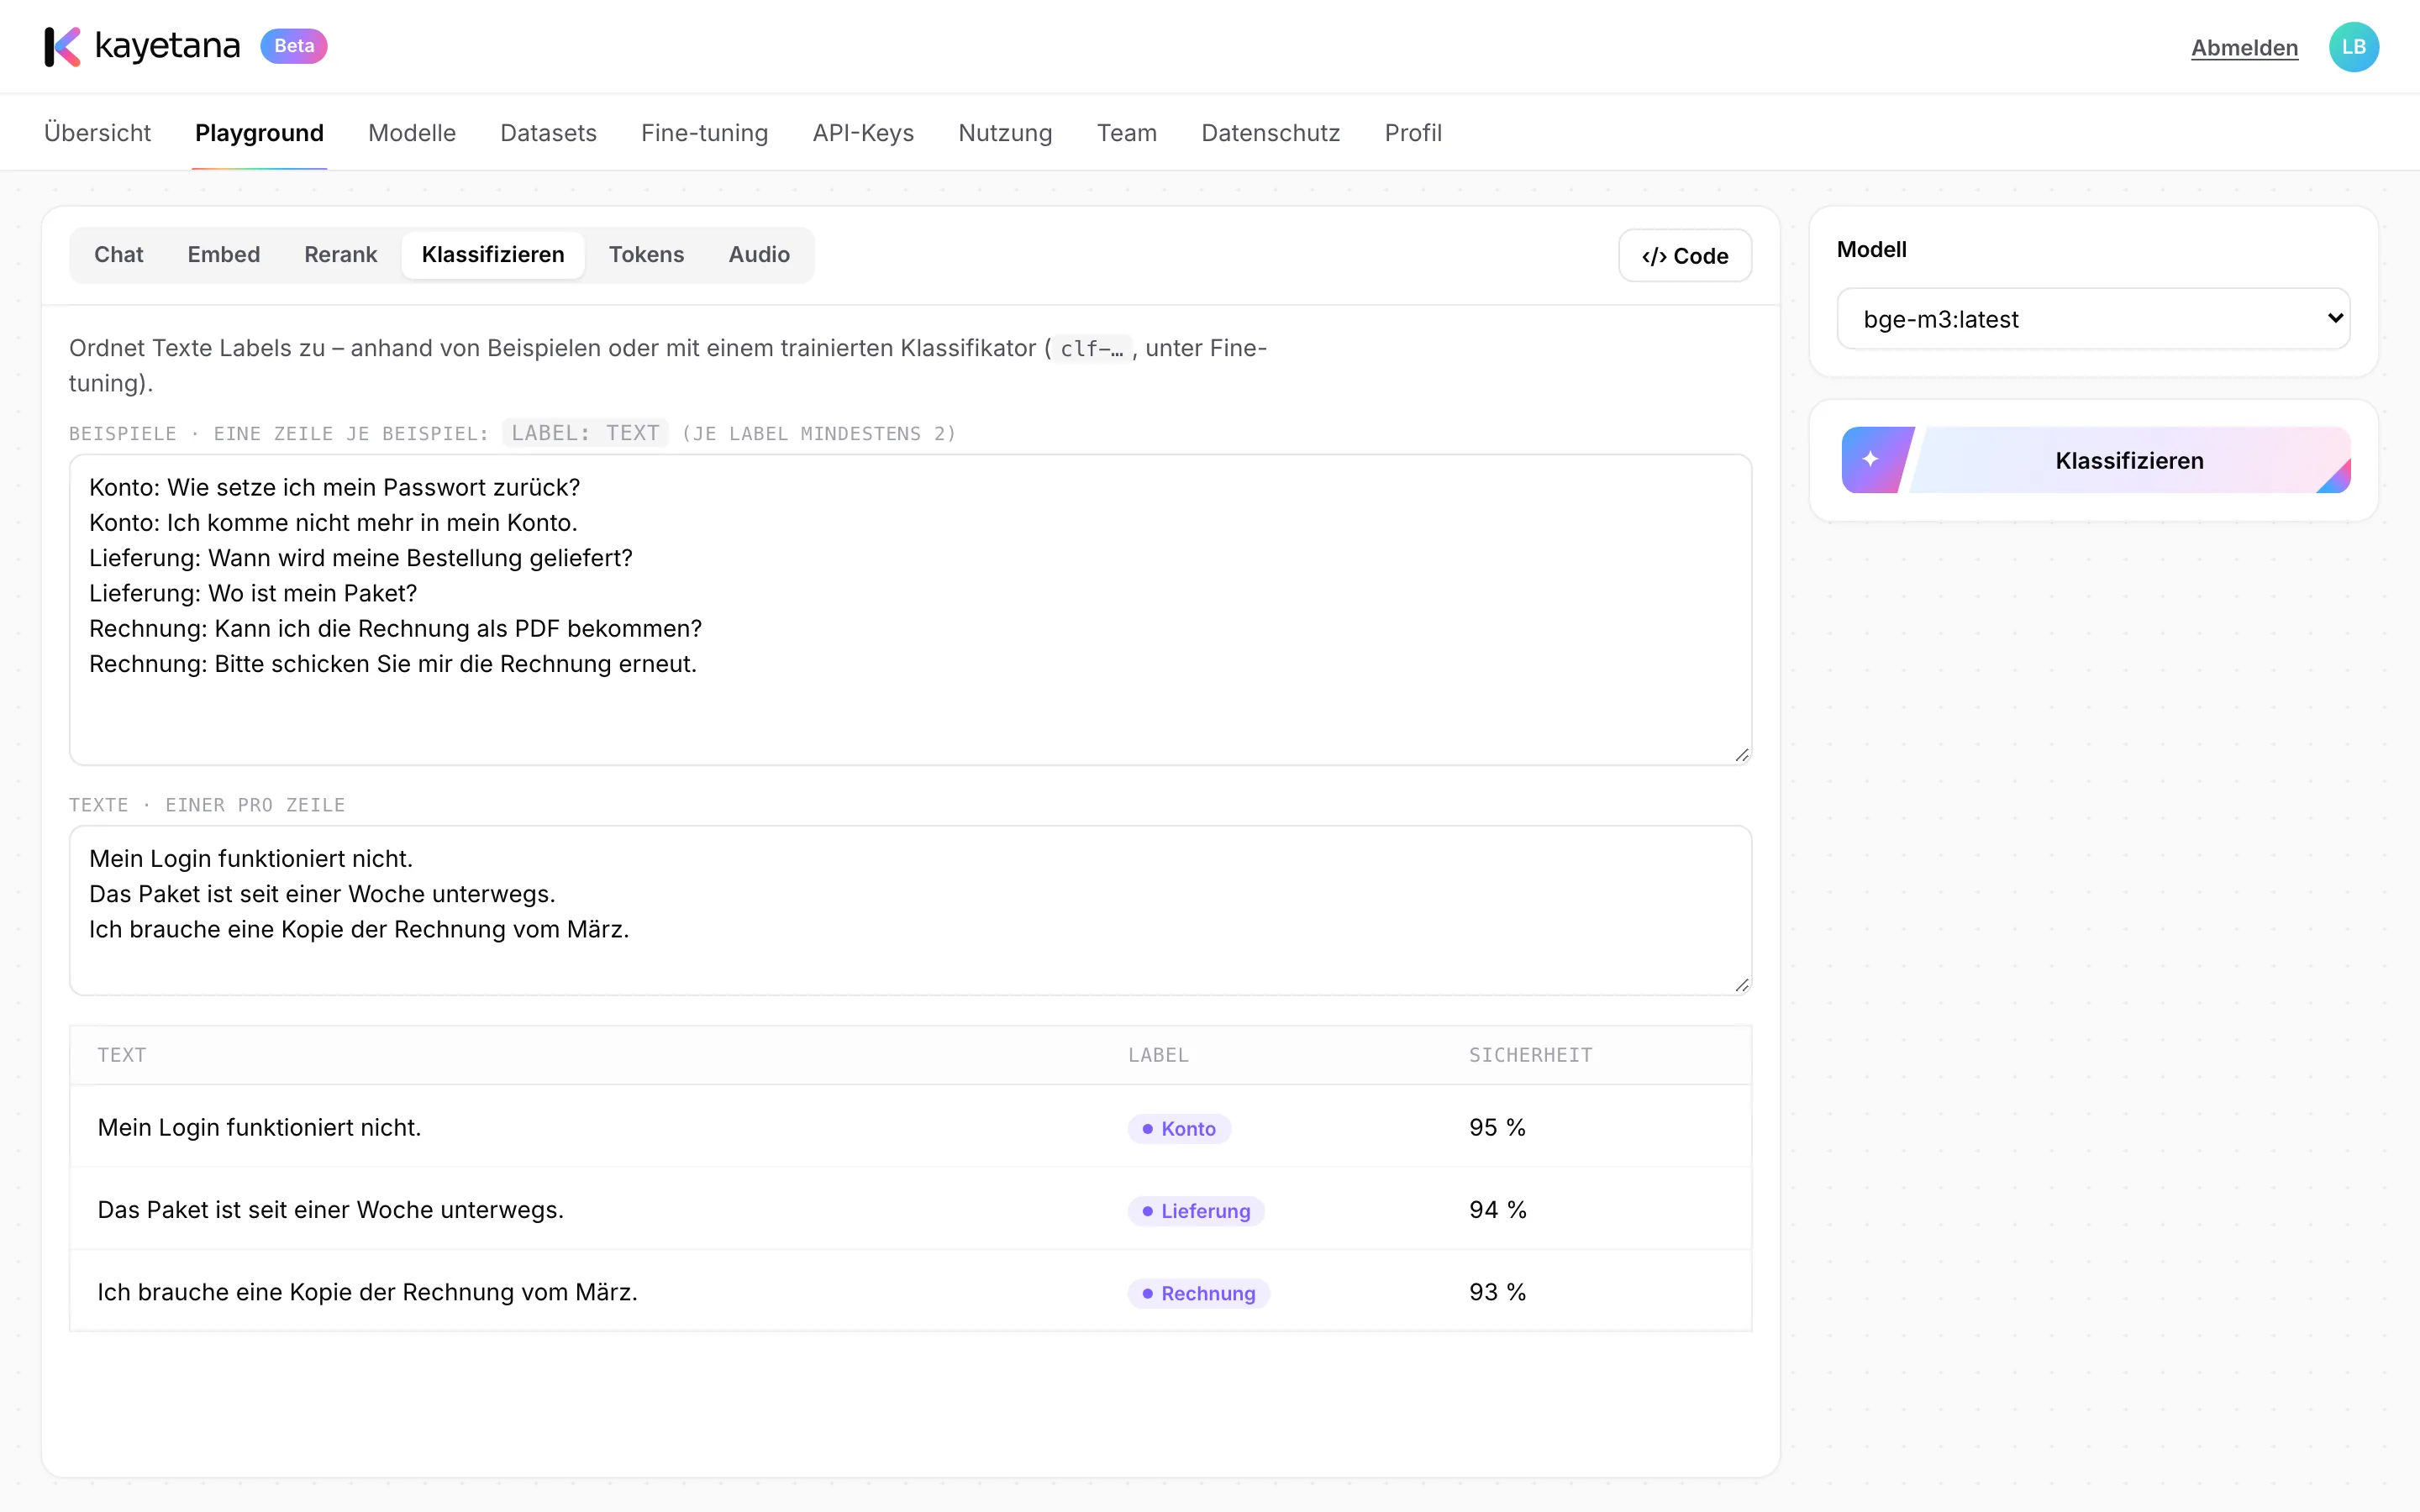
Convierte un dataset etiquetado en un clasificador, «clf-name», basado en un modelo de embedding.
Se queda en casa
Los datos de entrenamiento y los modelos terminados están en tu servidor, no en un servicio en la nube.
Cómo se crea tu propio modelo de chat.
Reúne ejemplos
Buenas conversaciones del día a día, como las respuestas de tu equipo de soporte a preguntas frecuentes.
Sube un dataset
Sube los ejemplos como dataset de fine-tuning de chat.
Inicia el entrenamiento
kayetana hace fine-tuning de qwen3:4b-instruct con LoRA.
Usa el modelo
Tu nuevo modelo, «ft-name», está listo en el Playground y a través de la API.
Tus categorías, entrenadas.
Cuando tus categorías están definidas, como los temas de tu sistema de tickets, conviene un clasificador propio. Entrénalo una vez con un dataset etiquetado y úsalo en el Playground y por API como cualquier otro clasificador.
- Una o varias etiquetas por texto
- Basado en un modelo de embedding
- Confianza por etiqueta en el resultado
¿Modelo de chat o clasificador?
| Fine-tuning de chat | Clasificador | |
|---|---|---|
| Resultado | Tu propio modelo, «ft-name» | Clasificador, «clf-name» |
| Basado en | qwen3:4b-instruct | Modelo de embedding |
| Datos de entrenamiento | Ejemplos de conversación | Textos etiquetados |
| Uso típico | Tono, estructura y contenido de las respuestas | Clasificar tickets y correos |
Convierte tus ejemplos en tu propio modelo.
En una demo te mostramos cómo funciona el fine-tuning con tus datos.
Preguntas frecuentes
¿Qué modelo puedo ajustar con fine-tuning?
Actualmente qwen3:4b-instruct, con LoRA. Los clasificadores se basan en un modelo de embedding.
¿Qué datos necesito?
Para un modelo de chat, ejemplos de conversación como dataset de fine-tuning de chat. Para un clasificador, textos con una o varias etiquetas.
¿Dónde se guardan mis datos de entrenamiento?
En tu servidor. En la página de privacidad defines un plazo de conservación para los datasets, tras el cual se eliminan automáticamente.
¿Cómo uso el modelo terminado?
Aparece como «ft-name» o «clf-name» y está disponible en el Playground y a través de la REST API.