 kayetana
La voz se convierte en texto. Sin que la grabación salga nunca de la empresa.
Sube una grabación, elige el idioma y obtén una transcripción con marcas de tiempo. Whisper large-v3-turbo funciona directamente en tu propio servidor.
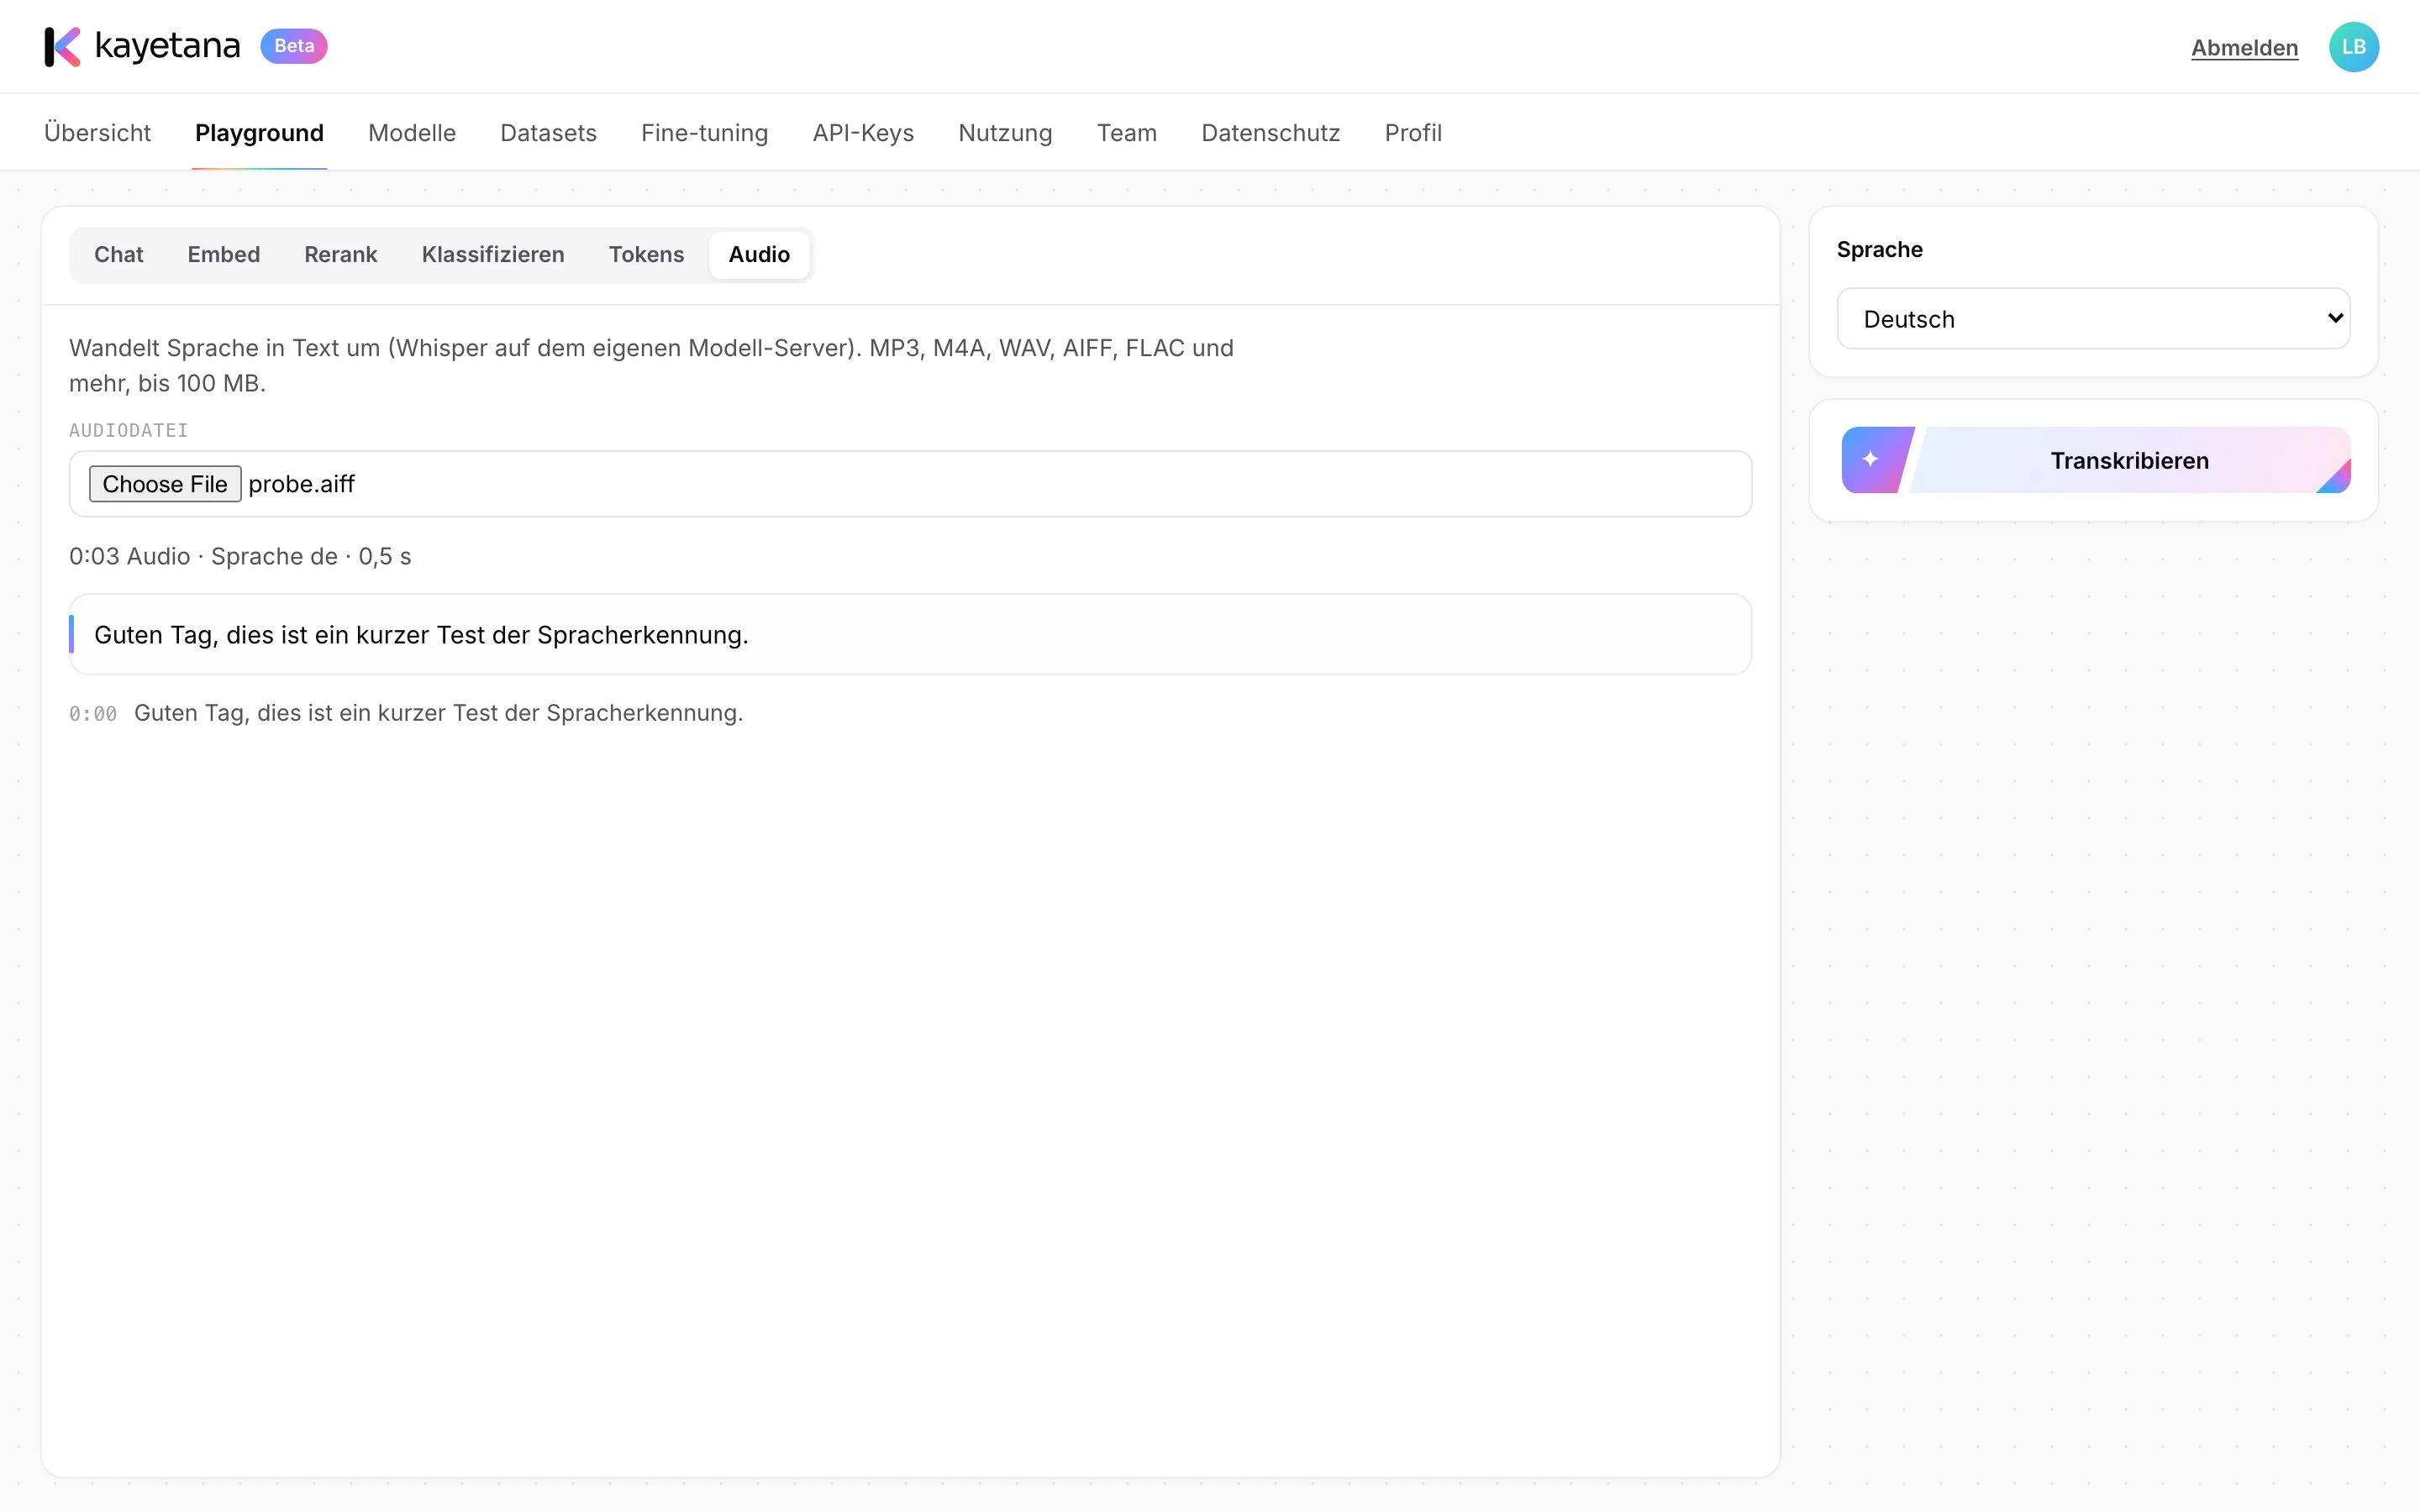
Elige un archivo, transcribe, listo.
En el Playground, elige el archivo de audio y el idioma e inicia la transcripción. Obtienes el texto completo y cada segmento con su marca de tiempo, para ir después directamente al punto exacto de la grabación.
- Whisper large-v3-turbo
- Elige el idioma
- Marcas de tiempo por segmento
Donde las transcripciones ahorran tiempo.
Reuniones
Sube la grabación de la reunión de equipo y usa la transcripción como base para el acta.
Mensajes de voz
Lee los mensajes de voz largos de clientes o compañeros en lugar de escucharlos.
Entrevistas
Ten por escrito entrevistas de trabajo o llamadas con clientes y revísalas a tu ritmo.
Dictado
Dicta sobre la marcha y sigue editando el texto de vuelta en la oficina.
Marcas de tiempo
Cada segmento tiene una marca de tiempo, así encuentras ese momento en la grabación al instante.
Siguientes pasos
Resume la transcripción en el chat o haz que extraiga las tareas pendientes.
De la grabación al acta de la reunión.
Sube la grabación
El archivo de la reunión, por ejemplo un M4A de tu móvil, de hasta 100 MB.
Elige el idioma
Indica el idioma de la grabación e inicia la transcripción.
Resumir
En el chat, convierte la transcripción en un resumen breve con decisiones y tareas.
Lo que admite kayetana.
- MP3, M4A, WAV, AIFF, FLAC y más
- Archivos de hasta 100 MB
- Marcas de tiempo en el resultado
- Idioma de grabación seleccionable
- También por API con el endpoint transcribe
- Procesado en tu propio servidor
Escucha menos, lee más.
Trae una grabación de muestra y te enseñamos la transcripción con marcas de tiempo en la demo.
Preguntas frecuentes
¿Qué formatos de archivo funcionan?
MP3, M4A, WAV, AIFF, FLAC y otros formatos habituales, de hasta 100 MB por archivo.
¿Qué modelo hace la transcripción?
Whisper large-v3-turbo. Tiene licencia abierta y funciona en tu propio servidor.
¿La grabación se envía a algún sitio?
No. La transcripción se ejecuta íntegramente en tu servidor, en tu red.
¿Puedo integrar la transcripción en mis propios flujos de trabajo?
Sí, a través del endpoint transcribe de la REST API, por ejemplo para convertir automáticamente en texto los mensajes de voz entrantes.