 kayetana
Busca por significado, no por palabras clave.
Embed convierte texto en vectores y rerank ordena documentos según lo bien que encajan con una pregunta. Así encuentras el pasaje correcto aunque use palabras distintas de las de tu búsqueda.
Lo que obtienes para tu búsqueda.
Embed
Convierte texto en vectores en los formatos float, int8, uint8, binary y ubinary.
Rerank
Ordena documentos por relevancia respecto a una pregunta, según la similitud de embeddings con bge-m3.
Vista 2D
El Playground representa los embeddings como puntos en un plano. Los textos similares quedan cerca unos de otros.
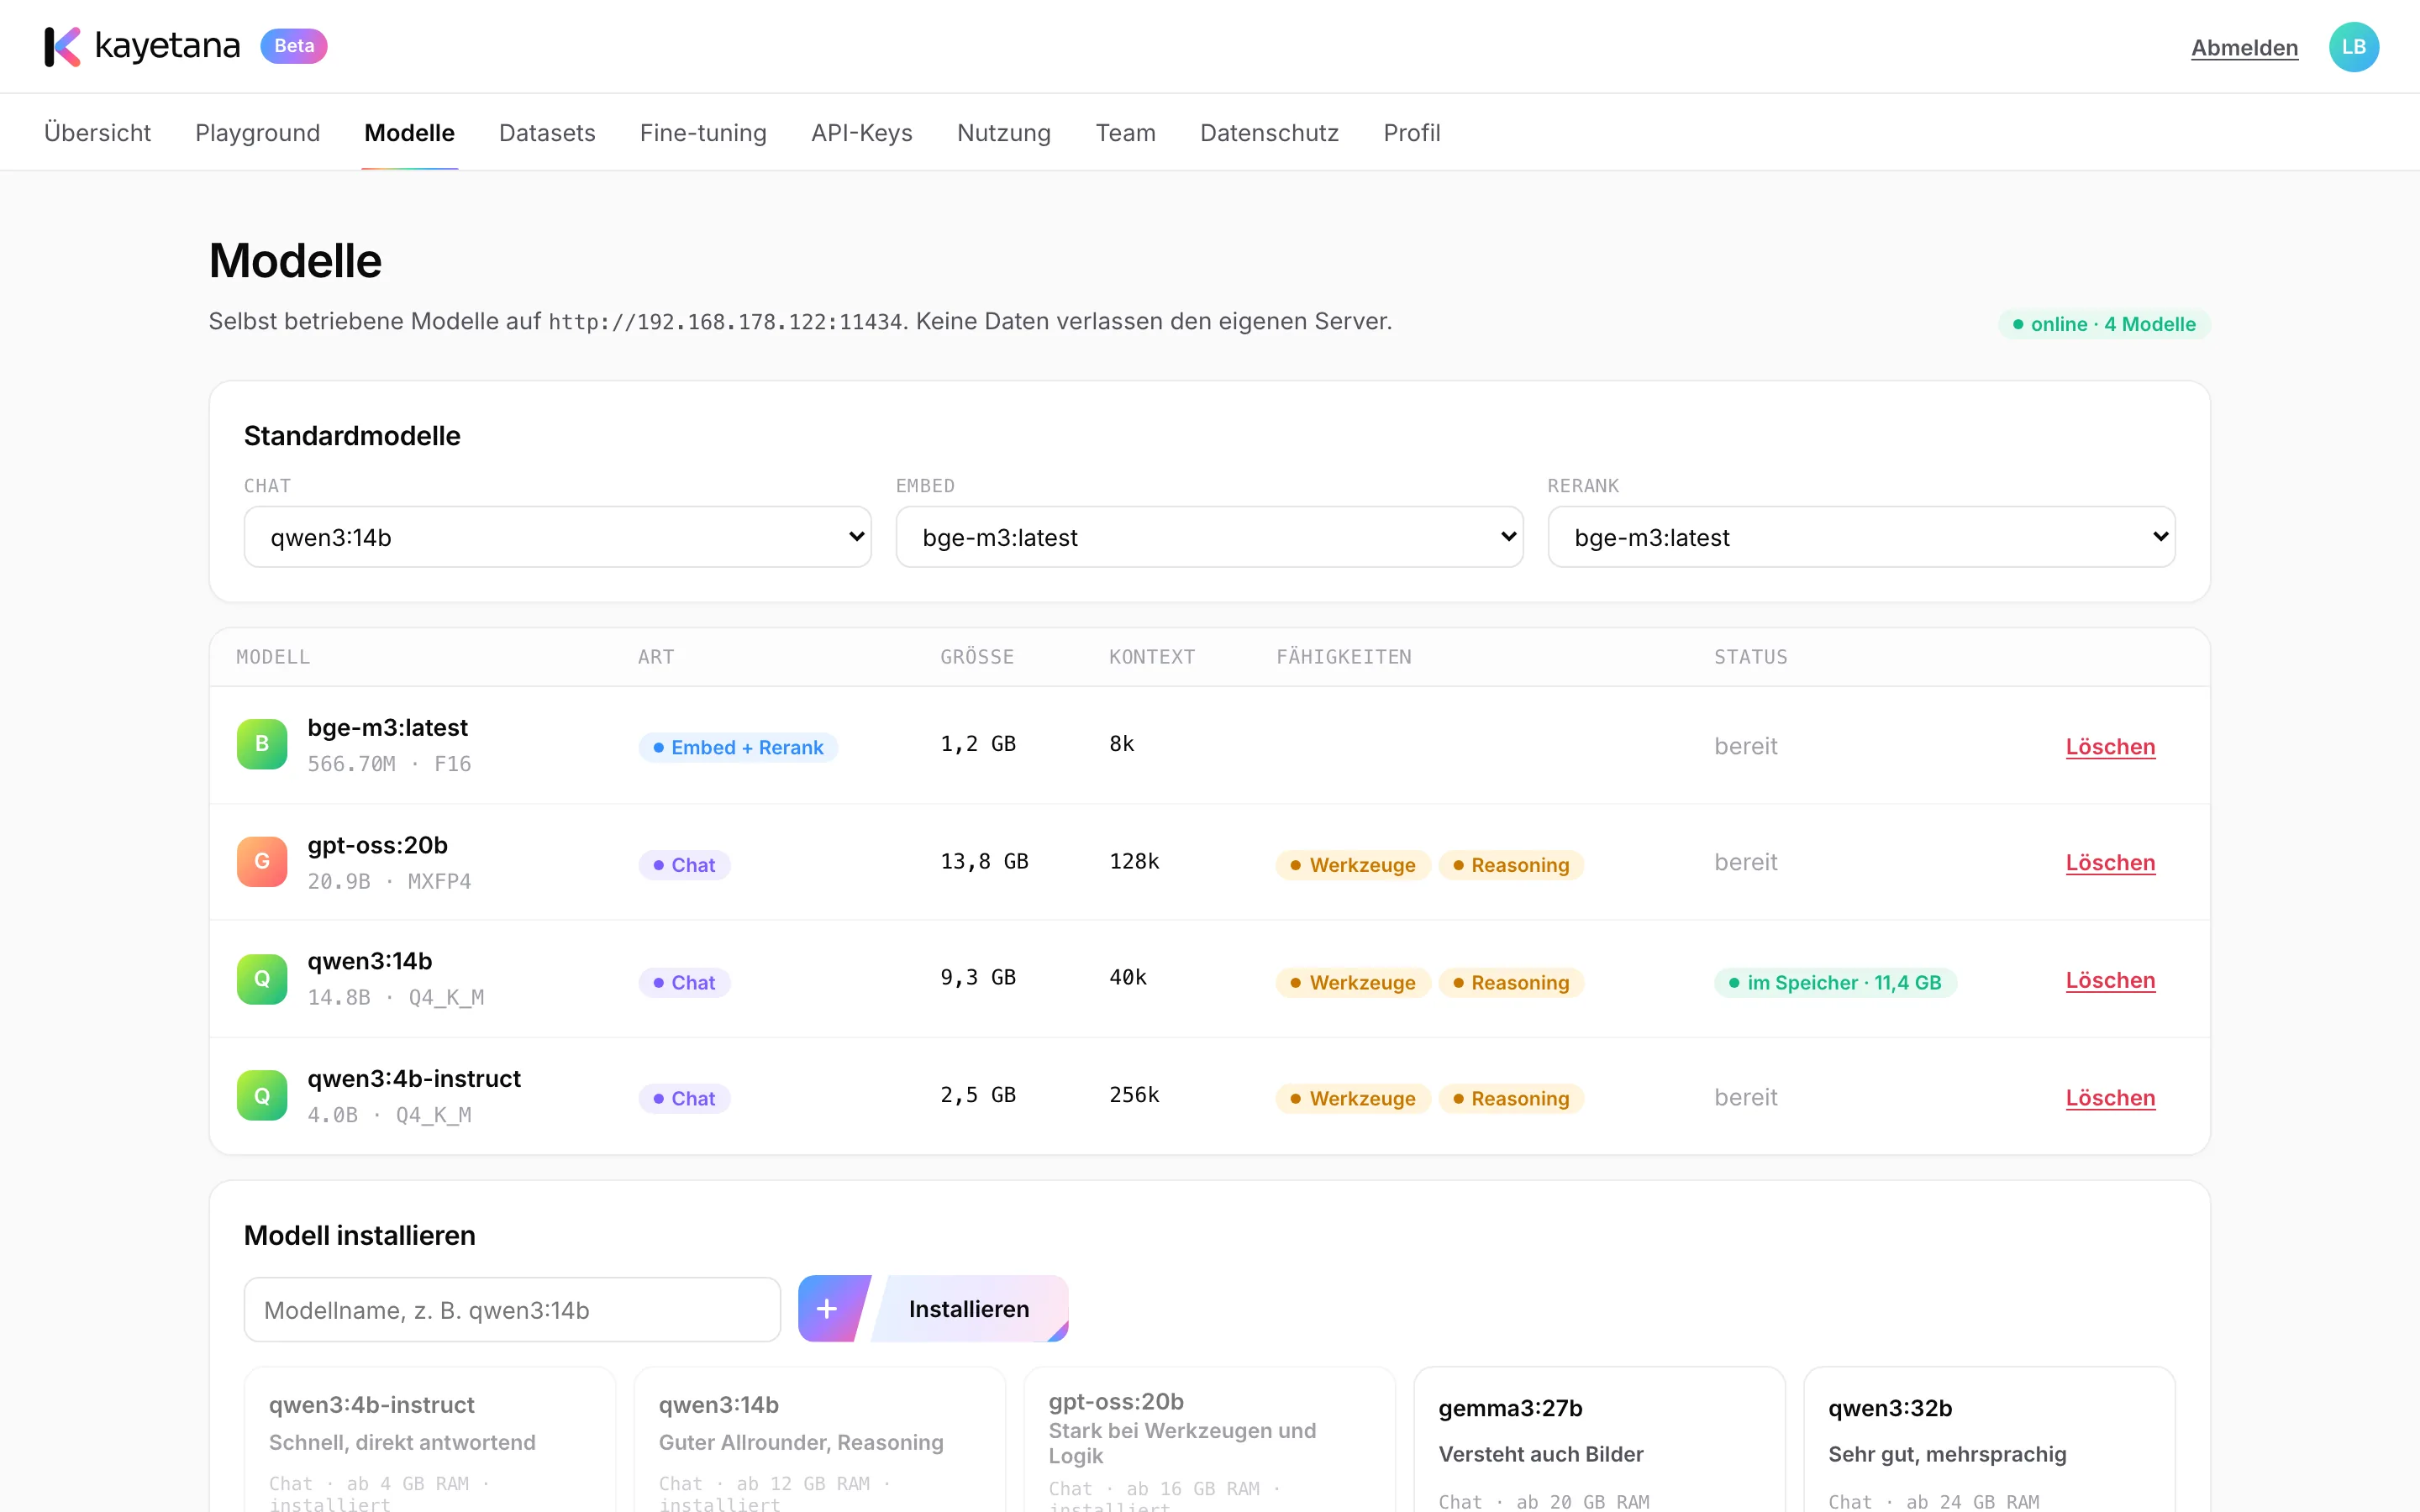
bge-m3 para embed y rerank, listo para usar.
En la lista de modelos eliges qué modelo se encarga por defecto de embed y rerank. bge-m3 viene incluido y puedes añadir otros modelos abiertos cuando los necesites.
- Un modelo predeterminado para cada tarea
- Tamaño y longitud de contexto de un vistazo
- Añade más modelos por su nombre
Busca en tus artículos de ayuda.
Genera embeddings de tu contenido
Sube tus artículos de ayuda como dataset y genera sus embeddings con un embed job en segundo plano. Obtienes el resultado en JSONL.
Genera el embedding de la pregunta
La consulta de un ticket de soporte se convierte en un vector con el mismo modelo.
Encuentra coincidencias
Tu aplicación compara los vectores y extrae los artículos más cercanos.
Rerank
Rerank ordena las coincidencias por relevancia respecto a la pregunta antes de mostrarlas.
Donde buscar por significado compensa.
- Asociar artículos de ayuda a tickets de soporte
- Encontrar contratos y cláusulas similares
- Detectar solicitudes duplicadas
- Sugerir textos estándar para propuestas
- Hacer consultables las bases de conocimiento internas
- Preseleccionar documentos antes de una respuesta con fuentes
Encuentra lo que se esconde en tus textos.
En una demo te mostramos embed y rerank funcionando con tu propio contenido.
Preguntas frecuentes
¿Qué diferencia hay entre embed y rerank?
Embed convierte textos individuales en vectores que puedes guardar y comparar. Rerank toma una pregunta y varios documentos y los ordena por relevancia.
¿Rerank usa un cross-encoder?
No. Rerank ordena por similitud de embeddings con bge-m3.
¿Qué formatos de vector hay disponibles?
float, int8, uint8, binary y ubinary, para que elijas entre precisión completa y vectores más compactos.
¿Cómo genero embeddings de una colección grande?
Con un embed job. Sube un dataset y kayetana genera los embeddings en segundo plano, muestra el progreso y te entrega el resultado como descarga JSONL.