 kayetana
Pesquise por significado, não por palavras-chave.
O embed converte texto em vetores e o rerank ordena documentos consoante a correspondência com uma pergunta. Assim encontra a passagem certa mesmo que use palavras diferentes das da sua pesquisa.
O que obtém para a sua pesquisa.
Embed
Converta texto em vetores nos formatos float, int8, uint8, binary e ubinary.
Rerank
Ordene documentos por relevância face a uma pergunta, com base na semelhança de embeddings com bge-m3.
Vista 2D
O Playground representa os embeddings como pontos num plano. Textos semelhantes ficam próximos uns dos outros.
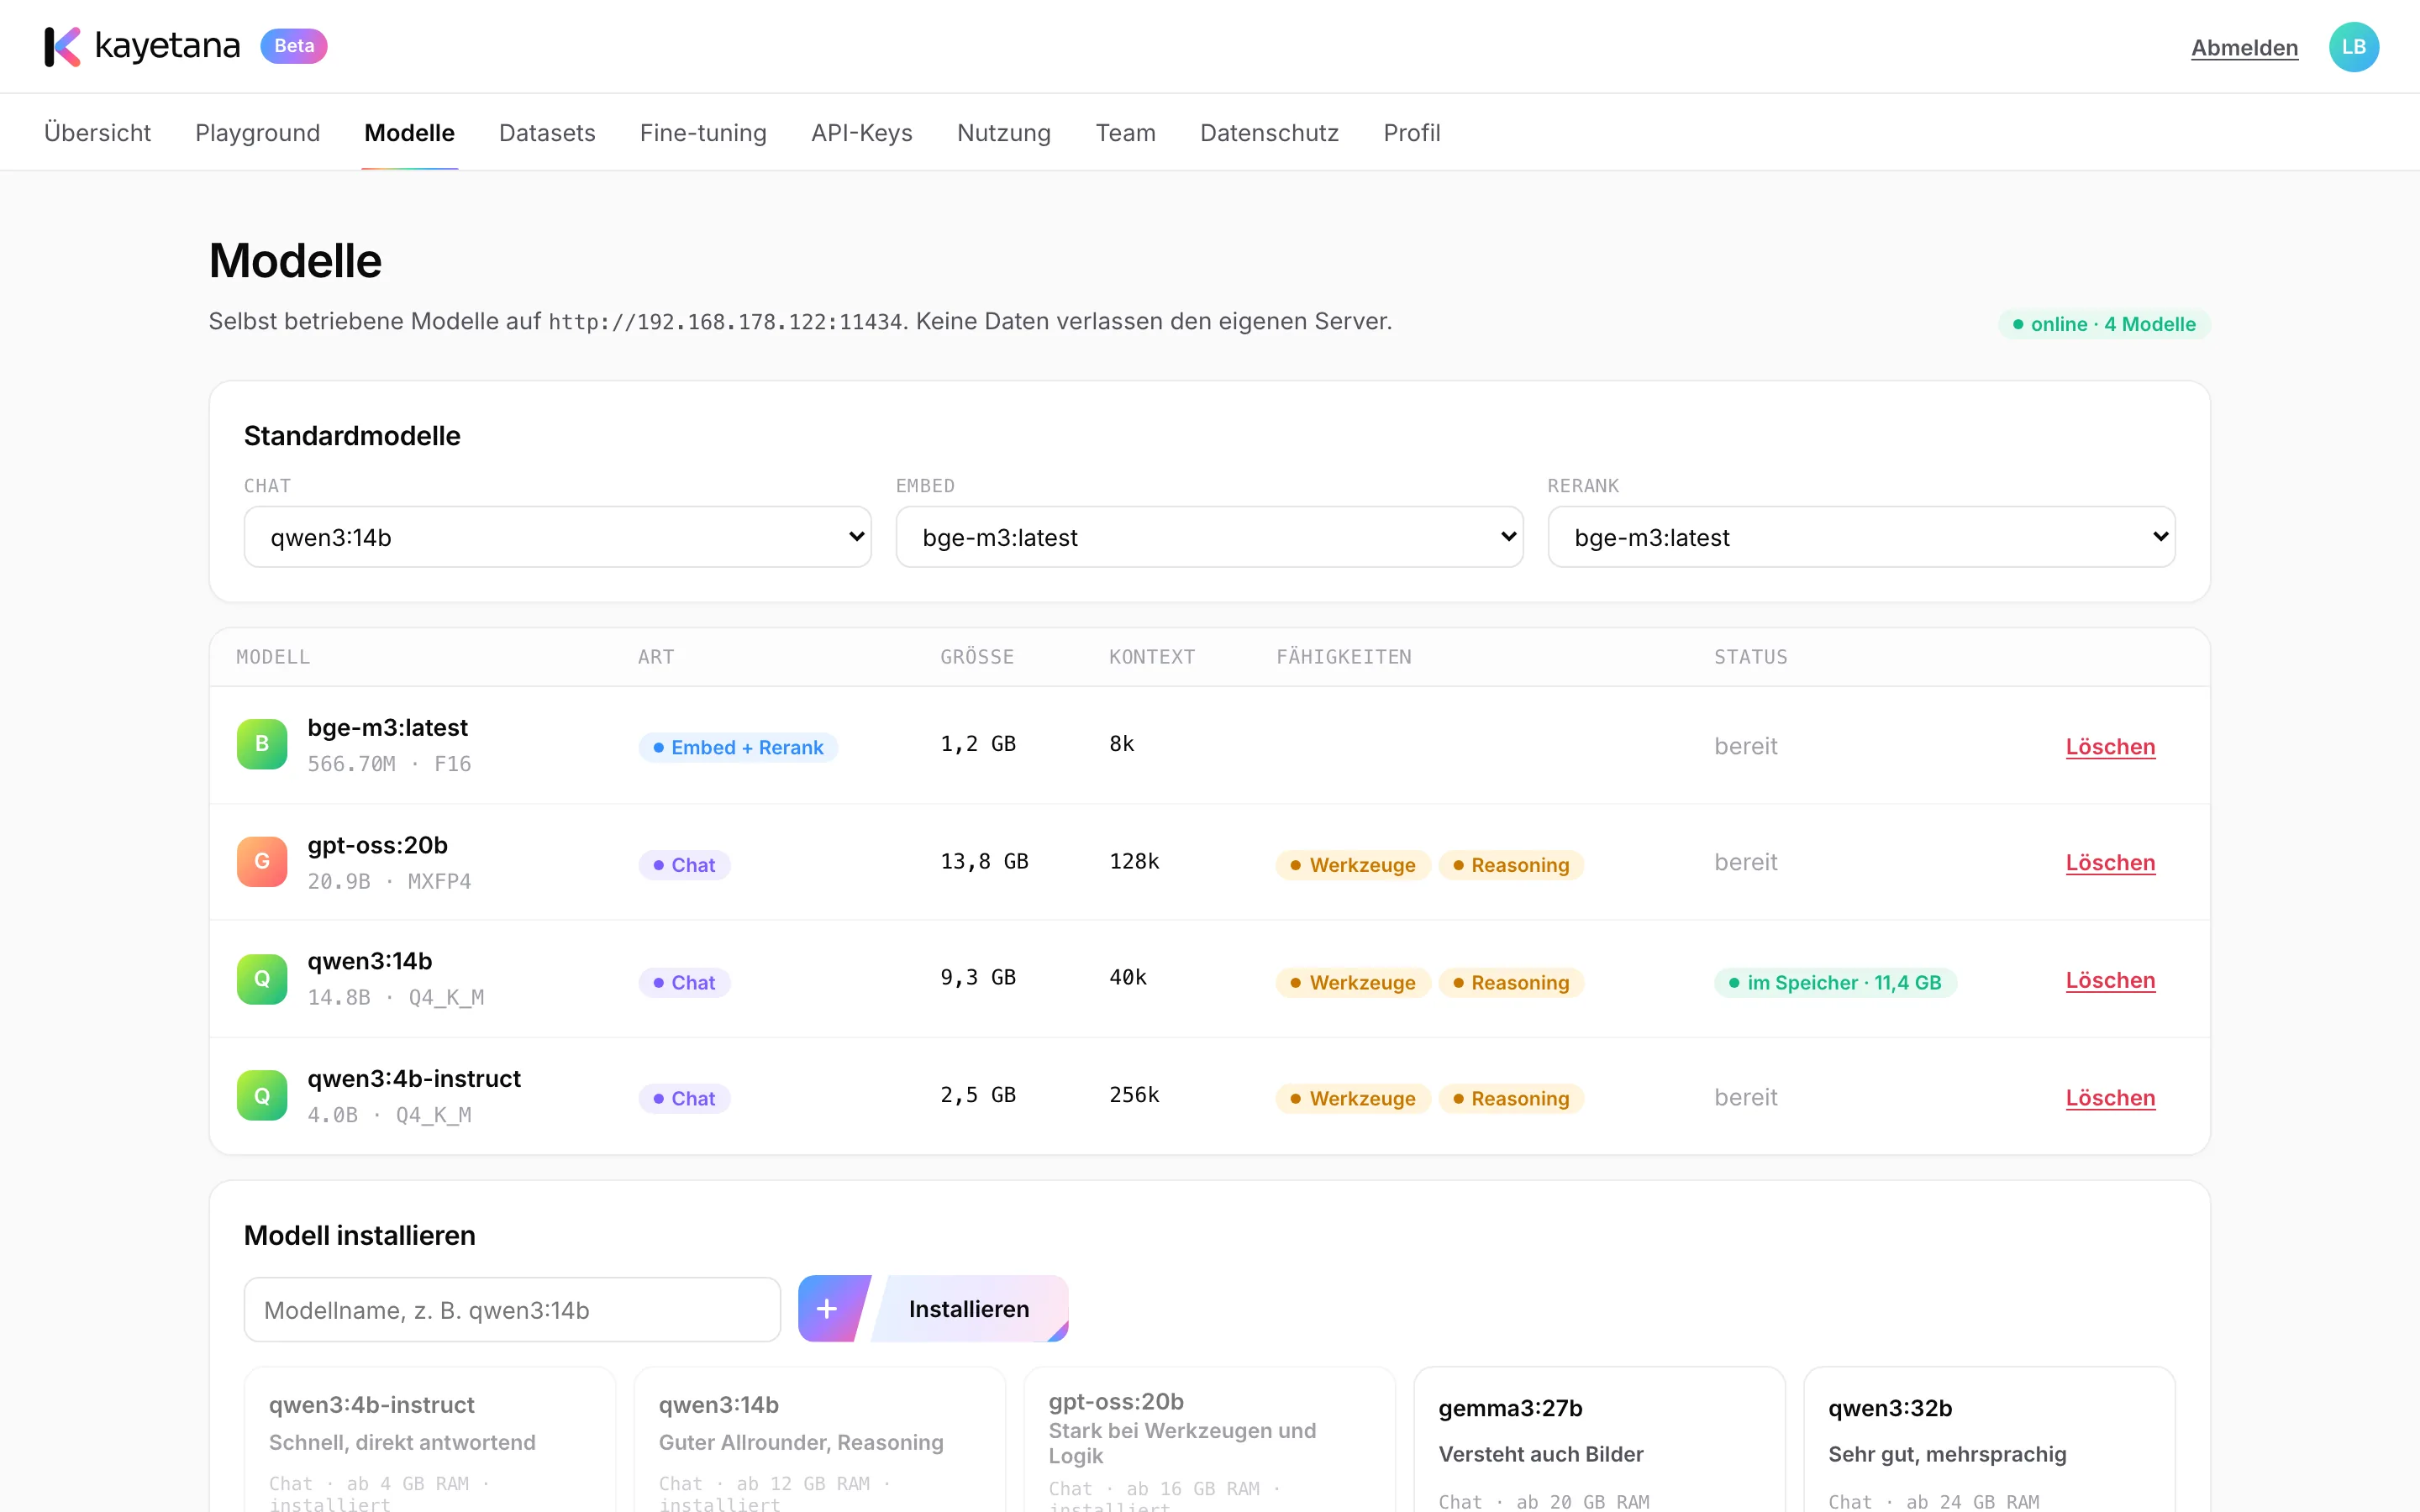
bge-m3 para embed e rerank, pronto a usar.
Na lista de modelos escolhe que modelo trata, por predefinição, do embed e do rerank. O bge-m3 vem incluído e pode adicionar outros modelos abertos sempre que precisar.
- Um modelo predefinido para cada tarefa
- Tamanho e comprimento de contexto num relance
- Adicione mais modelos pelo nome
Pesquise nos seus artigos de ajuda.
Gere embeddings do seu conteúdo
Carregue os seus artigos de ajuda como dataset e gere os embeddings com um embed job em segundo plano. Recebe o resultado em JSONL.
Gere o embedding da pergunta
A pesquisa de um ticket de suporte é convertida num vetor com o mesmo modelo.
Encontre correspondências
A sua aplicação compara os vetores e obtém os artigos mais próximos.
Rerank
O rerank ordena as correspondências por relevância face à pergunta antes de as mostrar.
Onde a pesquisa por significado compensa.
- Associar artigos de ajuda a tickets de suporte
- Encontrar contratos e cláusulas semelhantes
- Detetar pedidos duplicados
- Sugerir textos-padrão para propostas
- Tornar pesquisáveis as bases de conhecimento internas
- Pré-selecionar documentos antes de uma resposta com fontes
Encontre o que se esconde nos seus textos.
Numa demo, mostramos-lhe o embed e o rerank a funcionar com o seu próprio conteúdo.
Perguntas frequentes
Qual é a diferença entre embed e rerank?
O embed converte textos individuais em vetores que pode guardar e comparar. O rerank recebe uma pergunta e vários documentos e ordena-os por relevância.
O rerank usa um cross-encoder?
Não. O rerank ordena por semelhança de embeddings com bge-m3.
Que formatos de vetor estão disponíveis?
float, int8, uint8, binary e ubinary, para que possa escolher entre precisão total e vetores mais compactos.
Como gero embeddings de uma coleção grande?
Com um embed job. Carregue um dataset e o kayetana gera os embeddings em segundo plano, mostra o progresso e entrega-lhe o resultado como download JSONL.