 kayetana
Uma plataforma para tudo o que a sua equipa faz com IA.
O kayetana funciona num Mac Studio na sua própria rede. Experimenta modelos no browser, disponibiliza-os às suas próprias aplicações através da API e acompanha a utilização a qualquer momento. Os prompts e as respostas nunca são guardados.
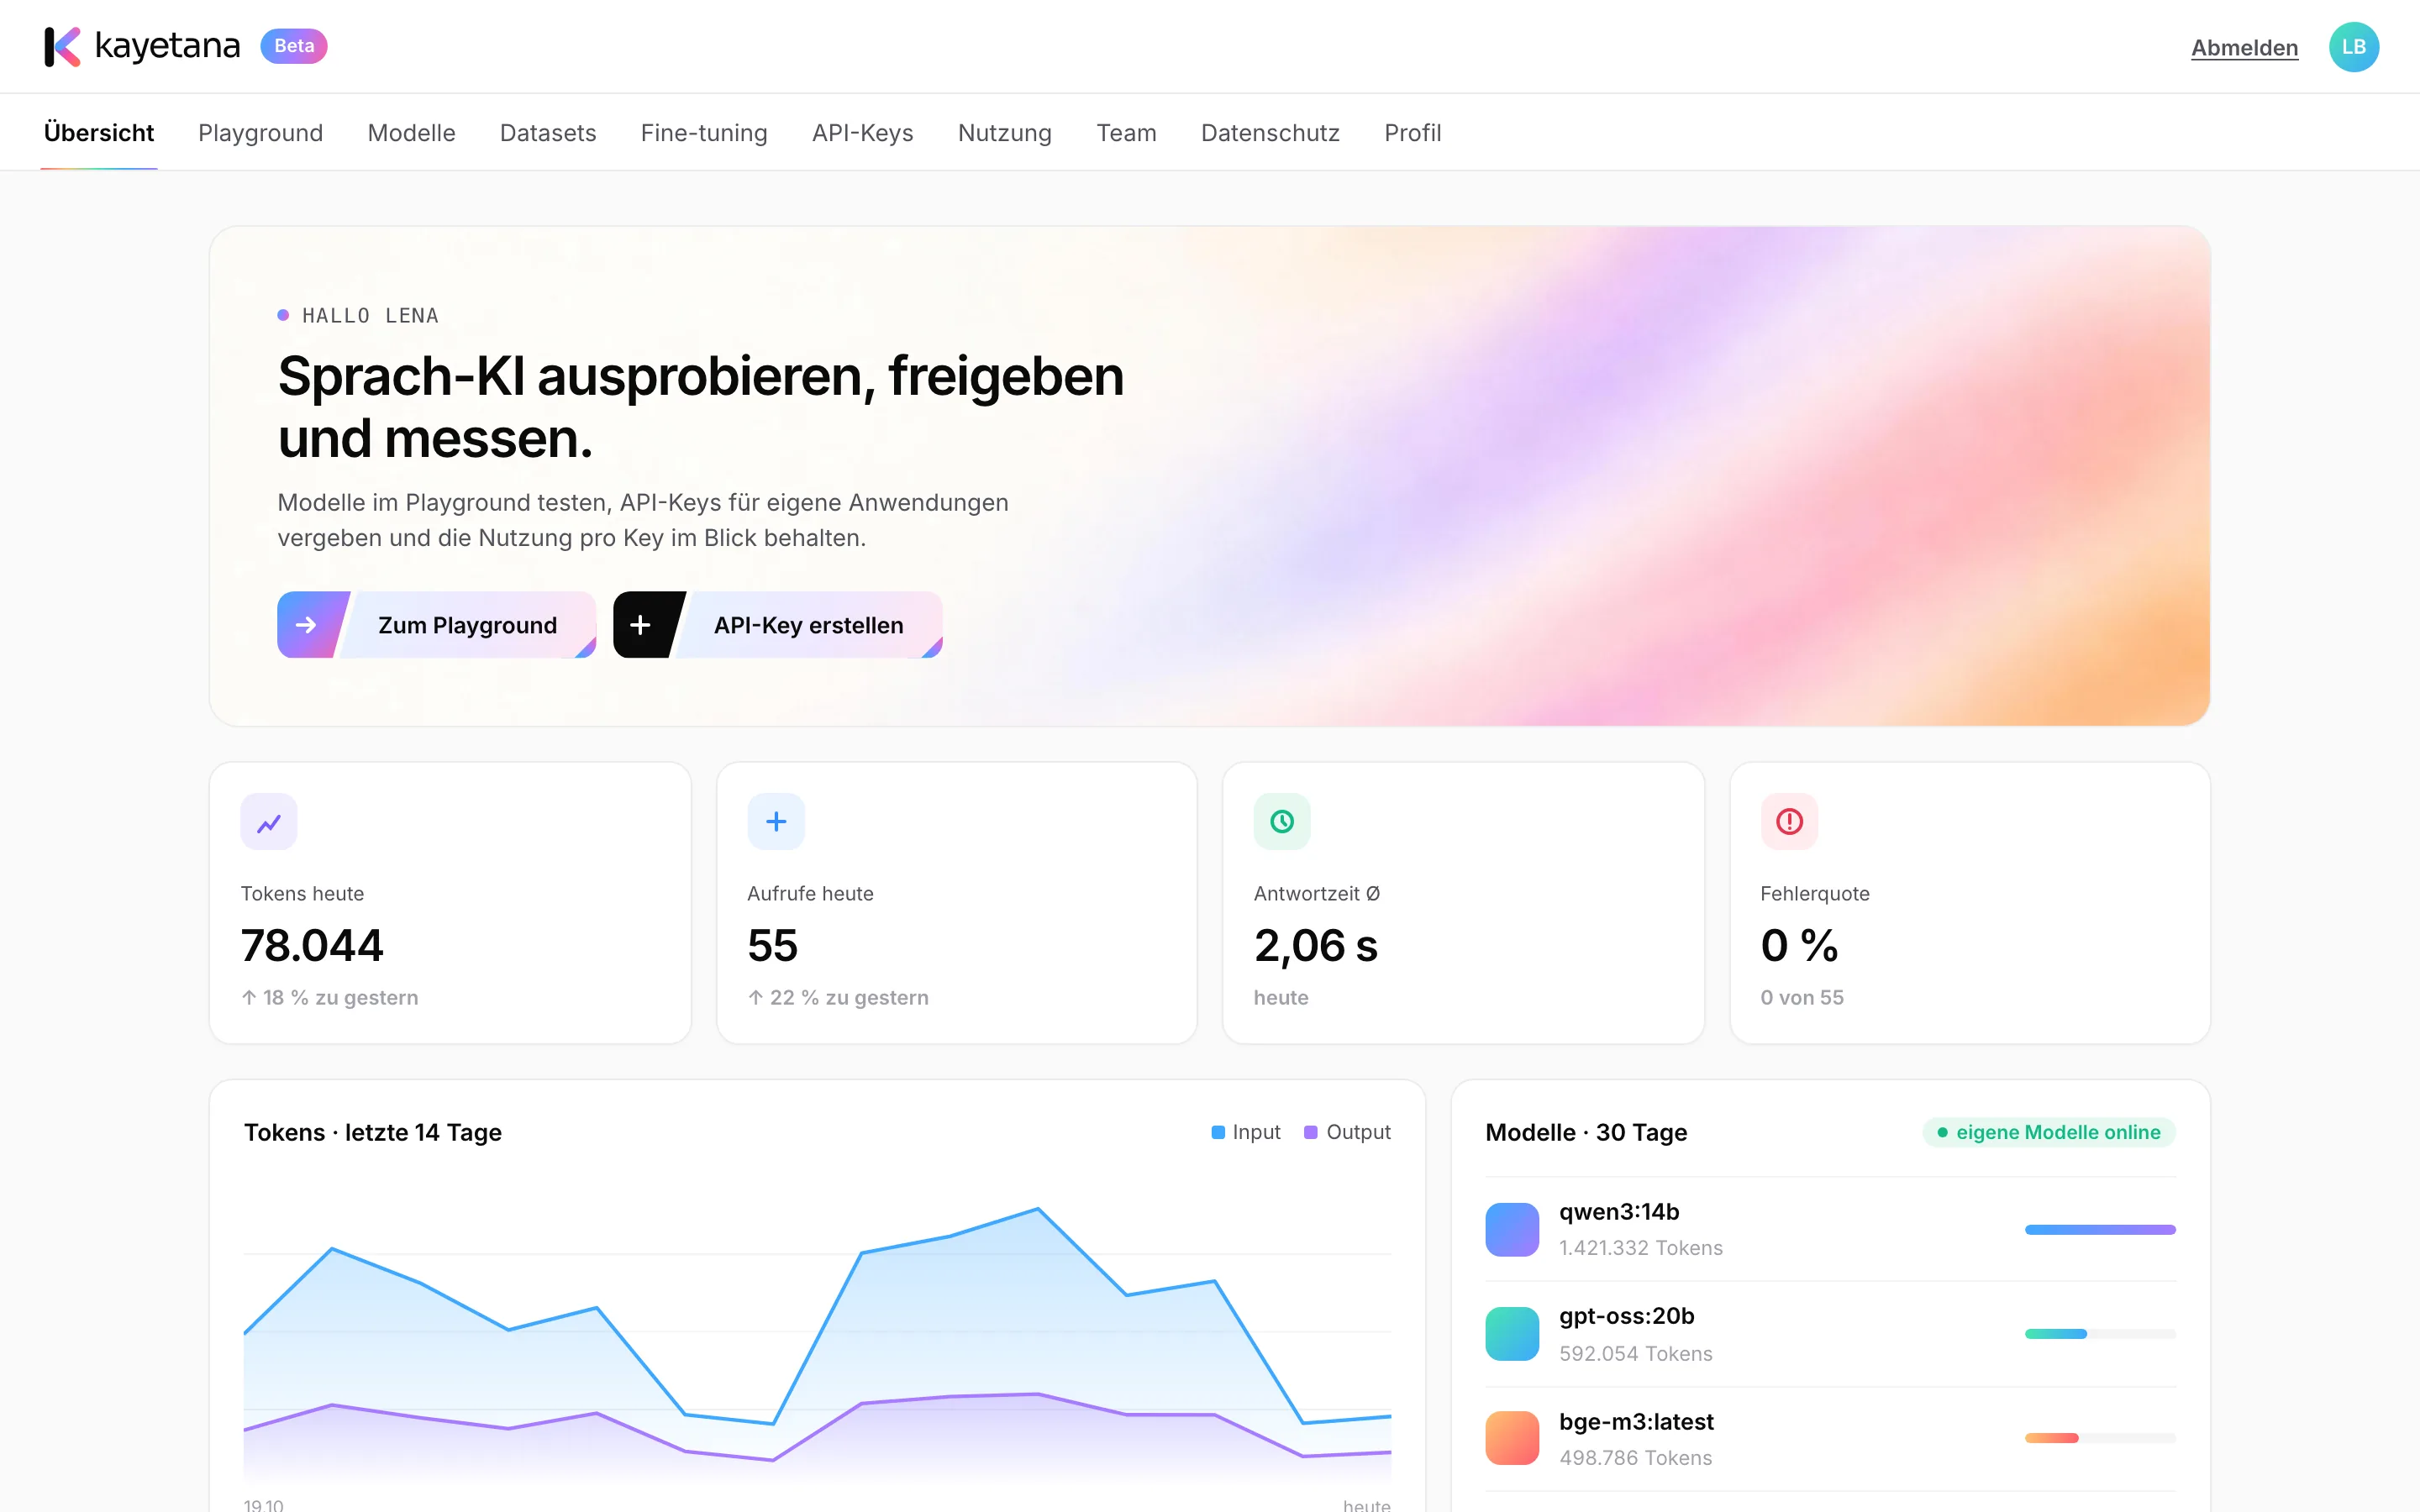
Teste modelos no browser: instruções de sistema, raciocínio, JSON, imagens, ferramentas e código pronto a usar.
Saber mais →Respostas a partir de documentosFaça perguntas sobre políticas, contratos e manuais. Cada afirmação indica a sua fonte.
Saber mais →Pesquisa: embed e rerankConverta texto em vetores e ordene-o por relevância: a base de uma pesquisa que entende o significado.
Saber mais →ClassificarEncaminhe tickets e e-mails para categorias automaticamente, com exemplos ou com o seu próprio classificador.
Saber mais →Áudio e transcriçãoTransforme reuniões e mensagens de voz em texto, com marcas temporais. Até 100 MB por ficheiro.
Saber mais →ModelosModelos abertos para chat, raciocínio, pesquisa e voz. Adicione novos e defina um predefinido para cada tarefa.
Saber mais →Fine-tuningTreine um modelo de chat com os seus próprios exemplos ou crie o seu próprio classificador.
Saber mais →Datasets e embed jobsCarregue ficheiros CSV, JSONL, TXT, PDF e Word e gere embeddings de coleções inteiras em segundo plano.
Saber mais →REST APITodas as funcionalidades numa REST API, com chaves de API, limites mensais por chave e código de exemplo pronto a usar.
Saber mais →Equipa e utilizaçãoFunções de proprietário, administrador e membro, links de convite ou início de sessão único, e uma visão completa da utilização.
Saber mais →As ferramentas que a sua equipa usa todos os dias.
Tudo funciona no seu próprio servidor e pode experimentar tudo de imediato no browser.
Chat e Playground
Experimente modelos diretamente no browser, com instruções de sistema, raciocínio, modo JSON e imagens.
Respostas a partir de documentos
Carregue políticas internas, contratos e manuais. Cada afirmação indica a fonte de onde vem.
Pesquisa com embed e rerank
Converta texto em vetores e ordene os resultados por relevância. A base de uma pesquisa que entende o significado.
Classificar
Encaminhe automaticamente tickets de suporte e e-mails para categorias, com exemplos ou com um classificador treinado por si.
Áudio
Transforme reuniões e mensagens de voz em texto, com marcas temporais. Até 100 MB por ficheiro.
Modelos
Modelos abertos para chat, raciocínio, pesquisa e voz. Adicione novos e defina os seus modelos predefinidos.
Os seus próprios modelos, as suas próprias aplicações, regras claras.
Fine-tuning
Treine um modelo de chat com os seus próprios exemplos de conversa ou crie um classificador a partir de dados etiquetados.
Datasets e embed jobs
Carregue ficheiros CSV, JSONL, TXT, PDF e Word e gere embeddings de coleções inteiras em segundo plano.
REST API
Todas as funcionalidades através de uma única API, com chaves de API e um limite mensal por chave.
Equipa e utilização
Funções de proprietário, administrador e membro. Tokens e pedidos por dia, chave e modelo.
Segurança e privacidade
Sem conteúdo guardado, prazos de conservação próprios, HTTPS na sua própria rede.
Funciona offline
Depois de descarregados os modelos, o funcionamento diário não precisa de internet.
Experimente antes de desenvolver seja o que for.
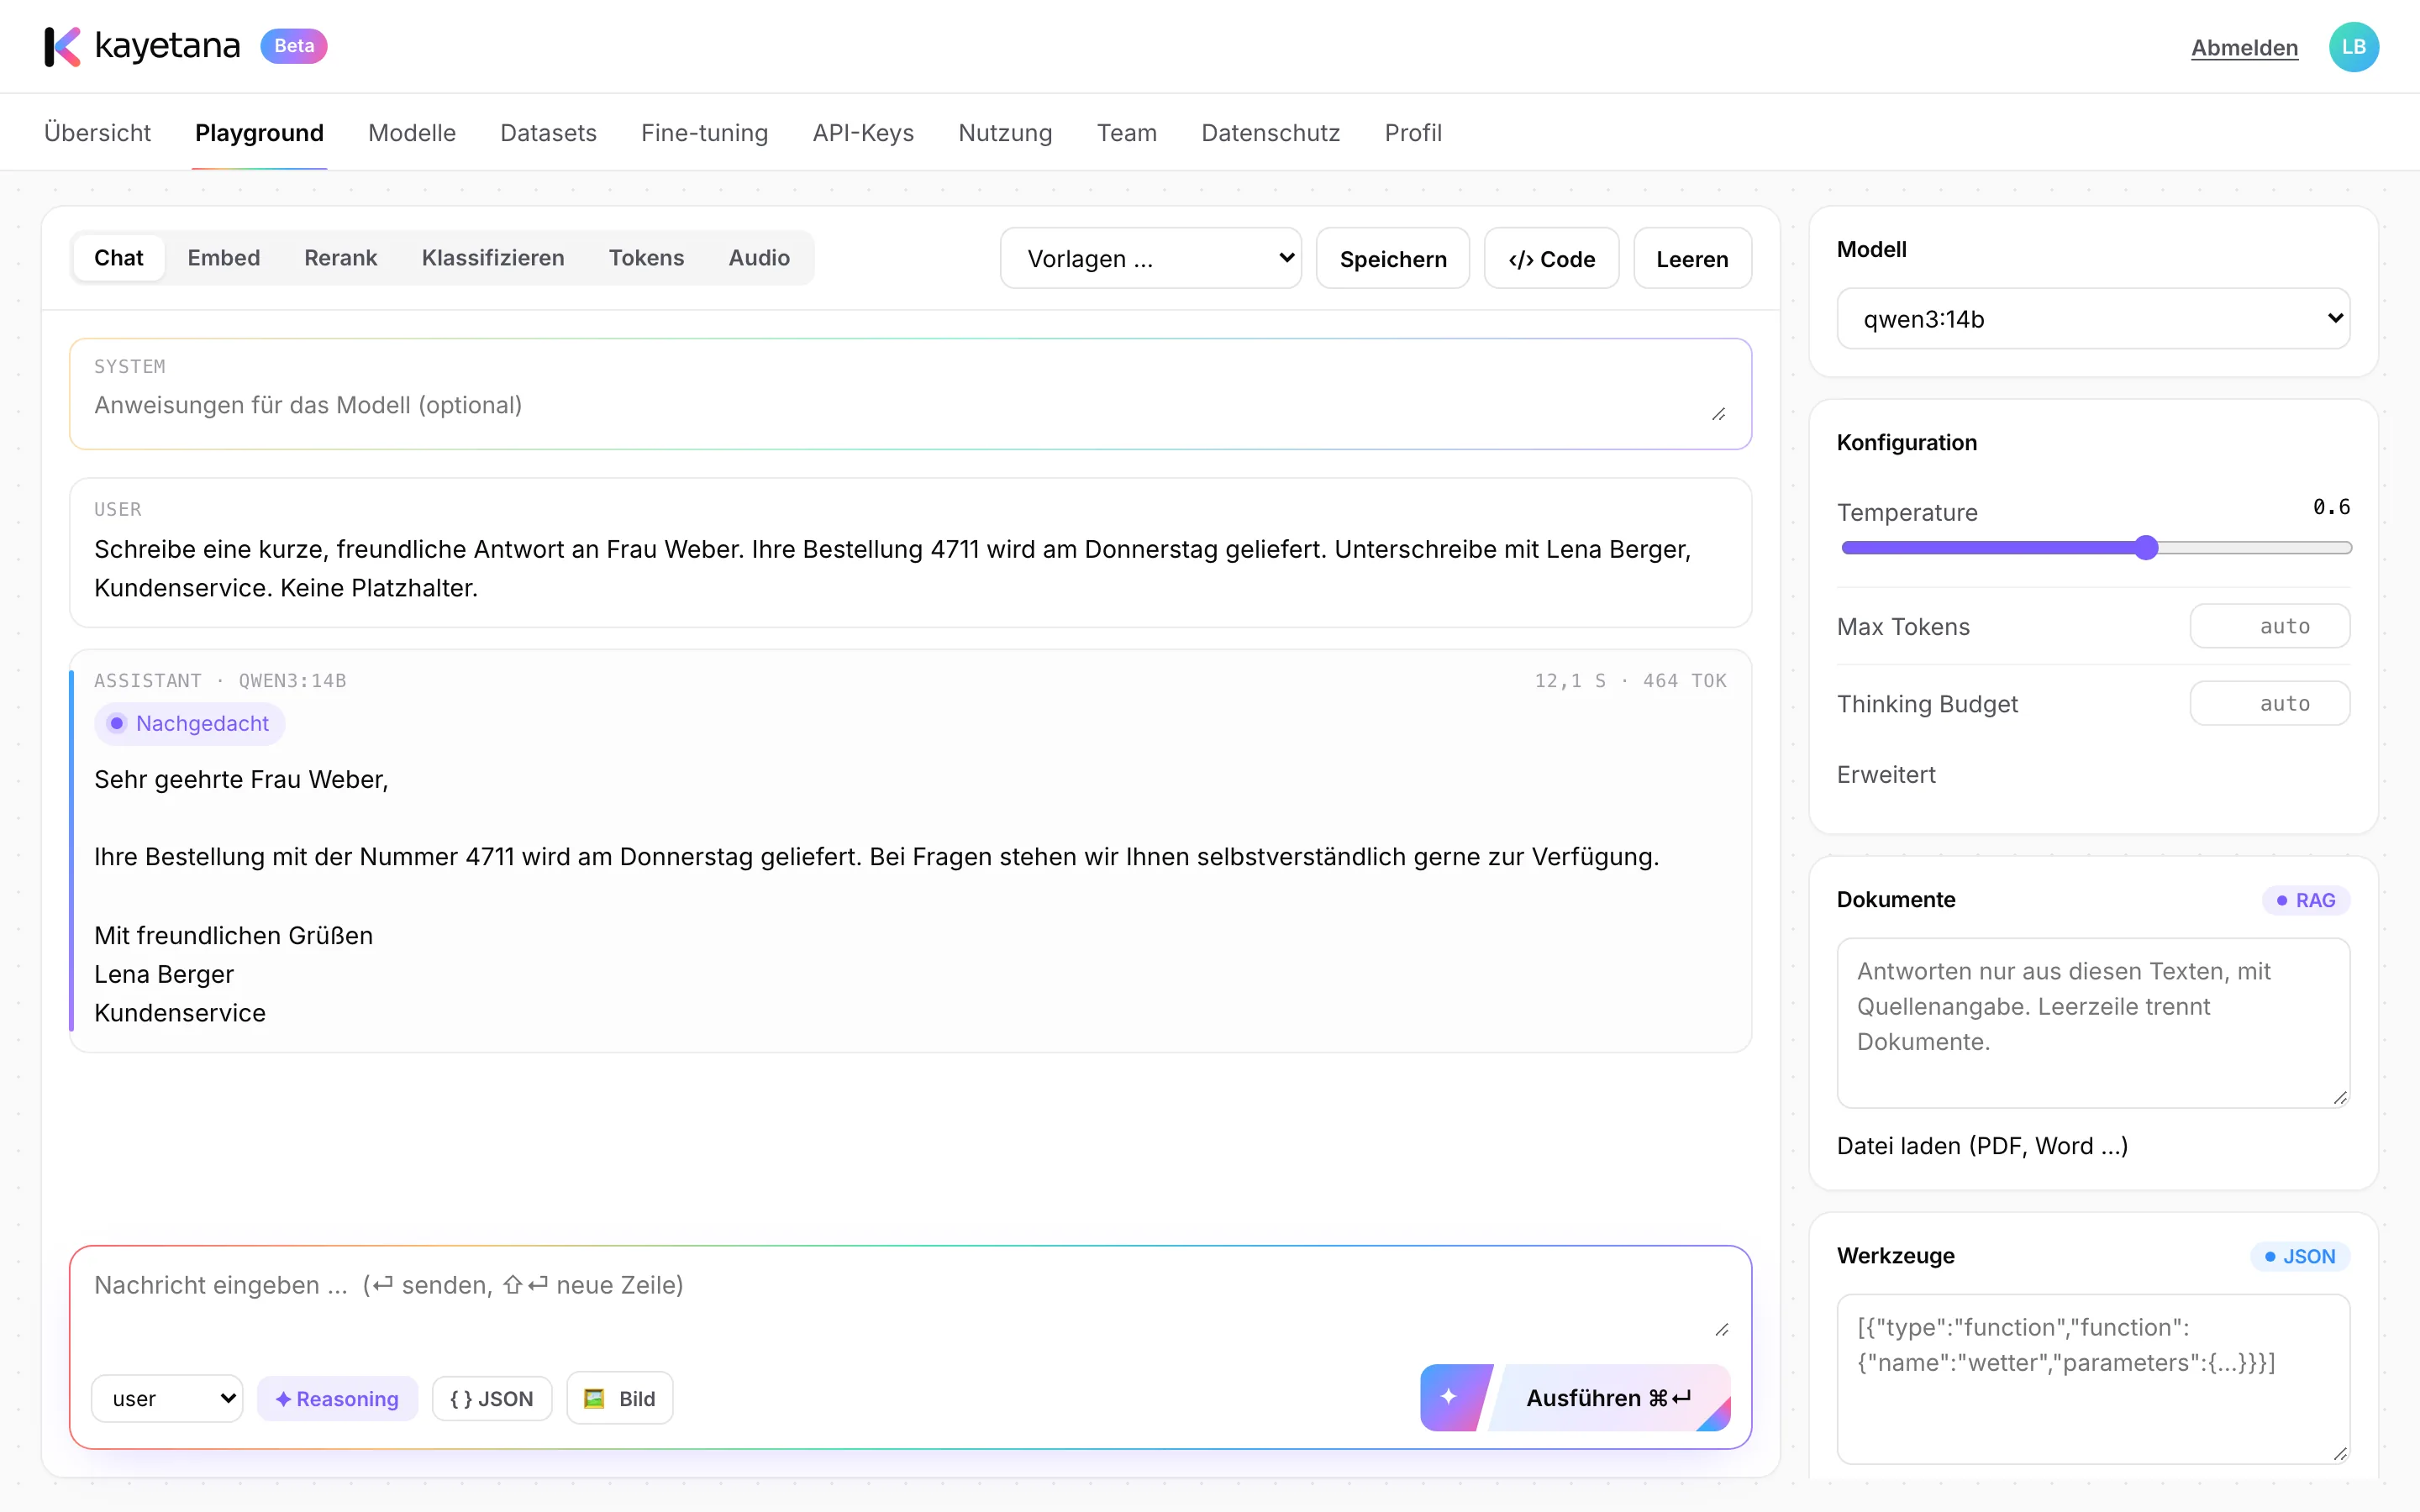
O Playground reúne chat, embed, rerank, classificação, tokens e áudio. Vê de imediato como um modelo responde à sua pergunta e copia exatamente essa configuração como código funcional em Python, TypeScript ou curl.
- Guarde presets para toda a equipa
- Código funcional para cada pedido
- Escolha o modelo e as definições para cada tarefa
De um teste rápido no browser à sua própria aplicação.
Experimentar
Teste modelos no Playground com exemplos reais do seu trabalho, como uma pergunta sobre a política de viagens.
Partilhar
Crie chaves de API para as suas aplicações, cada uma com o seu próprio limite mensal.
Adaptar
Use datasets e fine-tuning para ajustar os modelos às suas tarefas.
Acompanhar
A utilização mostra tokens, pedidos, tempo de resposta e taxa de erros por chave e modelo.
O que está por trás.
- Funciona num Mac Studio com Apple silicon
- Modelos servidos pelo Ollama na mesma máquina
- Serviço complementar para transcrição, tokenizador, leitura de documentos e fine-tuning
- Utilize-o no browser ou através da REST API
- HTTPS com o seu próprio certificado na sua própria rede
- Cópia de segurança diária às 3h15, guardada durante 14 dias
- Atualizações por script; os serviços arrancam sozinhos após um reinício
- Preço fixo em vez de faturação por token ou por utilizador
Conheça a plataforma com os seus próprios exemplos.
Numa demo, mostramos-lhe o kayetana com perguntas e documentos do seu próprio trabalho.
Perguntas frequentes
De que hardware preciso?
Um Mac Studio com Apple silicon. Recomendamos 36 GB de memória ou mais, o que permite correr modelos até cerca de 20 mil milhões de parâmetros, a par da pesquisa e da transcrição. Com mais memória pode usar modelos maiores.
Preciso de ligação à internet?
Apenas para descarregar modelos e atualizações. Depois disso, tudo funciona na sua própria rede.
Que modelos estão incluídos?
qwen3:4b-instruct, qwen3:14b e gpt-oss:20b para chat e raciocínio, bge-m3 para pesquisa, reranking e classificação, e Whisper large-v3-turbo para voz. Todos têm licença aberta (Apache 2.0 ou MIT).
Posso ligar o kayetana às minhas próprias aplicações?
Sim. Todas as funcionalidades estão disponíveis através da REST API, com chaves de API e um limite mensal por chave.
Quanto custa o kayetana?
Preço sob consulta. Paga um valor fixo pela plataforma, sem faturação por token nem por utilizador.