 kayetana
Classifique textos sem ler cada linha.
Tickets de suporte, e-mails, feedback: o kayetana atribui a cada texto uma ou várias etiquetas e indica o grau de confiança. Bastam alguns exemplos.
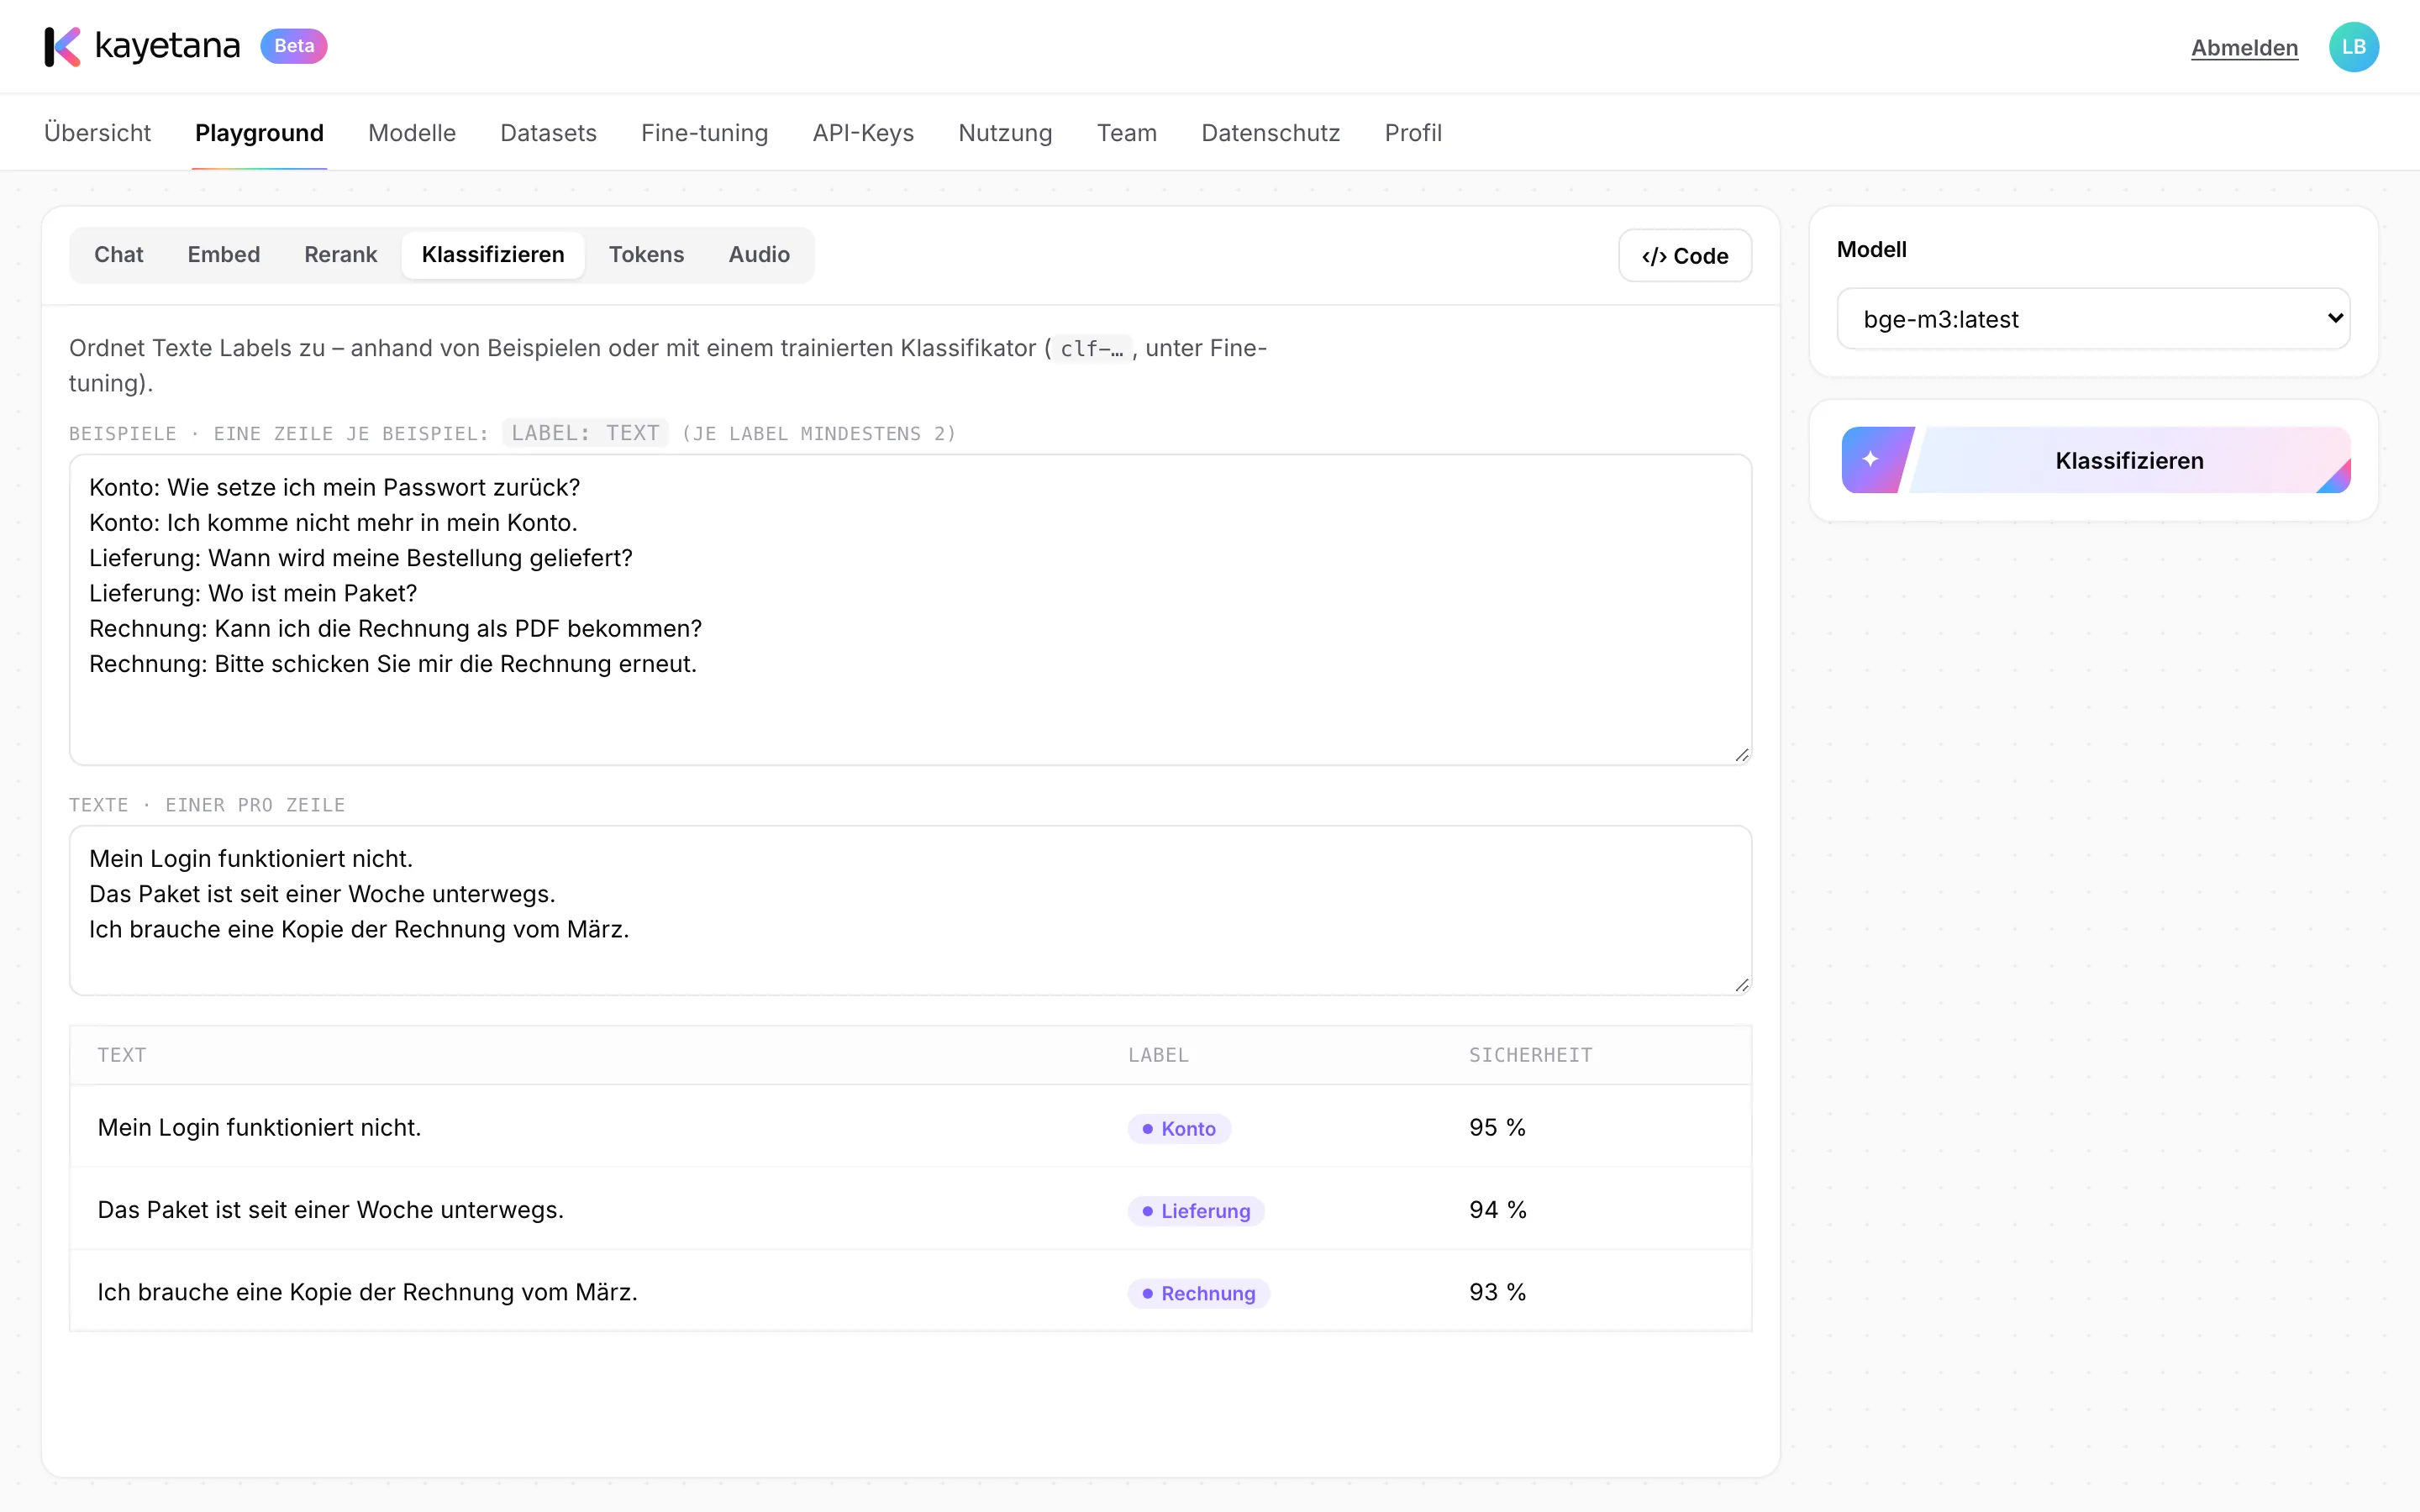
Entram exemplos, saem etiquetas.
Escreva alguns exemplos para cada etiqueta, por exemplo «Conta», «Envio» e «Faturação». Depois introduza textos novos. O kayetana atribui uma etiqueta a cada um e mostra a confiança em percentagem.
- Exemplos diretamente no pedido
- Confiança por etiqueta
- Uma ou várias etiquetas por texto
Com exemplos ou com o seu próprio classificador.
| Com exemplos | Classificador treinado | |
|---|---|---|
| Configuração | Alguns exemplos por etiqueta no pedido | Dataset etiquetado, treinado uma vez |
| Ideal para | Testes rápidos, categorias variáveis | Categorias fixas, grande volume |
| Uma ou várias etiquetas por texto | ✓ | ✓ |
| Confiança por etiqueta | ✓ | ✓ |
| Disponível por API | ✓ | ✓ |
Onde a classificação lhe tira trabalho.
Tickets de suporte
Organize os novos tickets por tema e envie-os diretamente para a equipa certa.
Caixa partilhada
Separe os e-mails do seu endereço geral em pedidos de informação, candidaturas, faturas e reclamações.
Feedback
Etiquete o feedback de clientes como positivo, neutro ou crítico.
Cláusulas contratuais
Associe cláusulas a temas como responsabilidade, duração ou proteção de dados.
Vários temas
Um e-mail sobre envio e faturação? Os textos podem ter mais do que uma etiqueta.
Reveja onde importa
A confiança por etiqueta mostra que casos devem ser revistos por uma pessoa.
Como criar a sua própria classificação.
Teste com exemplos
Use o Playground para verificar se as suas categorias se distinguem bem.
Crie um dataset
Carregue textos etiquetados, com uma ou várias etiquetas por texto.
Treine um classificador
Em Fine-tuning, transforme-o num classificador «clf-name» baseado num modelo de embedding.
Use-o por API
A sua aplicação envia textos para classificar e recebe etiquetas e confiança.
Organize os seus tickets automaticamente.
Traga alguns exemplos da sua caixa de entrada e mostramos-lhe os resultados na demo.
Perguntas frequentes
Quantos exemplos preciso?
Para a abordagem com exemplos, bastam alguns por etiqueta. Para o seu próprio classificador, cria um dataset de textos etiquetados.
Um texto pode ter mais do que uma etiqueta?
Sim. Os textos podem ter uma ou várias etiquetas, e o kayetana mostra a confiança de cada uma.
Que modelo faz o trabalho?
A classificação funciona com um modelo de embedding, e o bge-m3 vem incluído. Os classificadores treinados chamam-se «clf-name» e baseiam-se num modelo de embedding.
Como o ligo ao nosso sistema de tickets?
Através do endpoint classify da REST API. O seu sistema envia os textos e recebe etiquetas e confiança.