 kayetana
Texte sortieren, ohne jeden einzeln zu lesen.
Support-Tickets, Mails, Rückmeldungen: kayetana ordnet jeden Text einem oder mehreren Labels zu und zeigt, wie sicher die Zuordnung ist. Dafür reichen ein paar Beispiele.
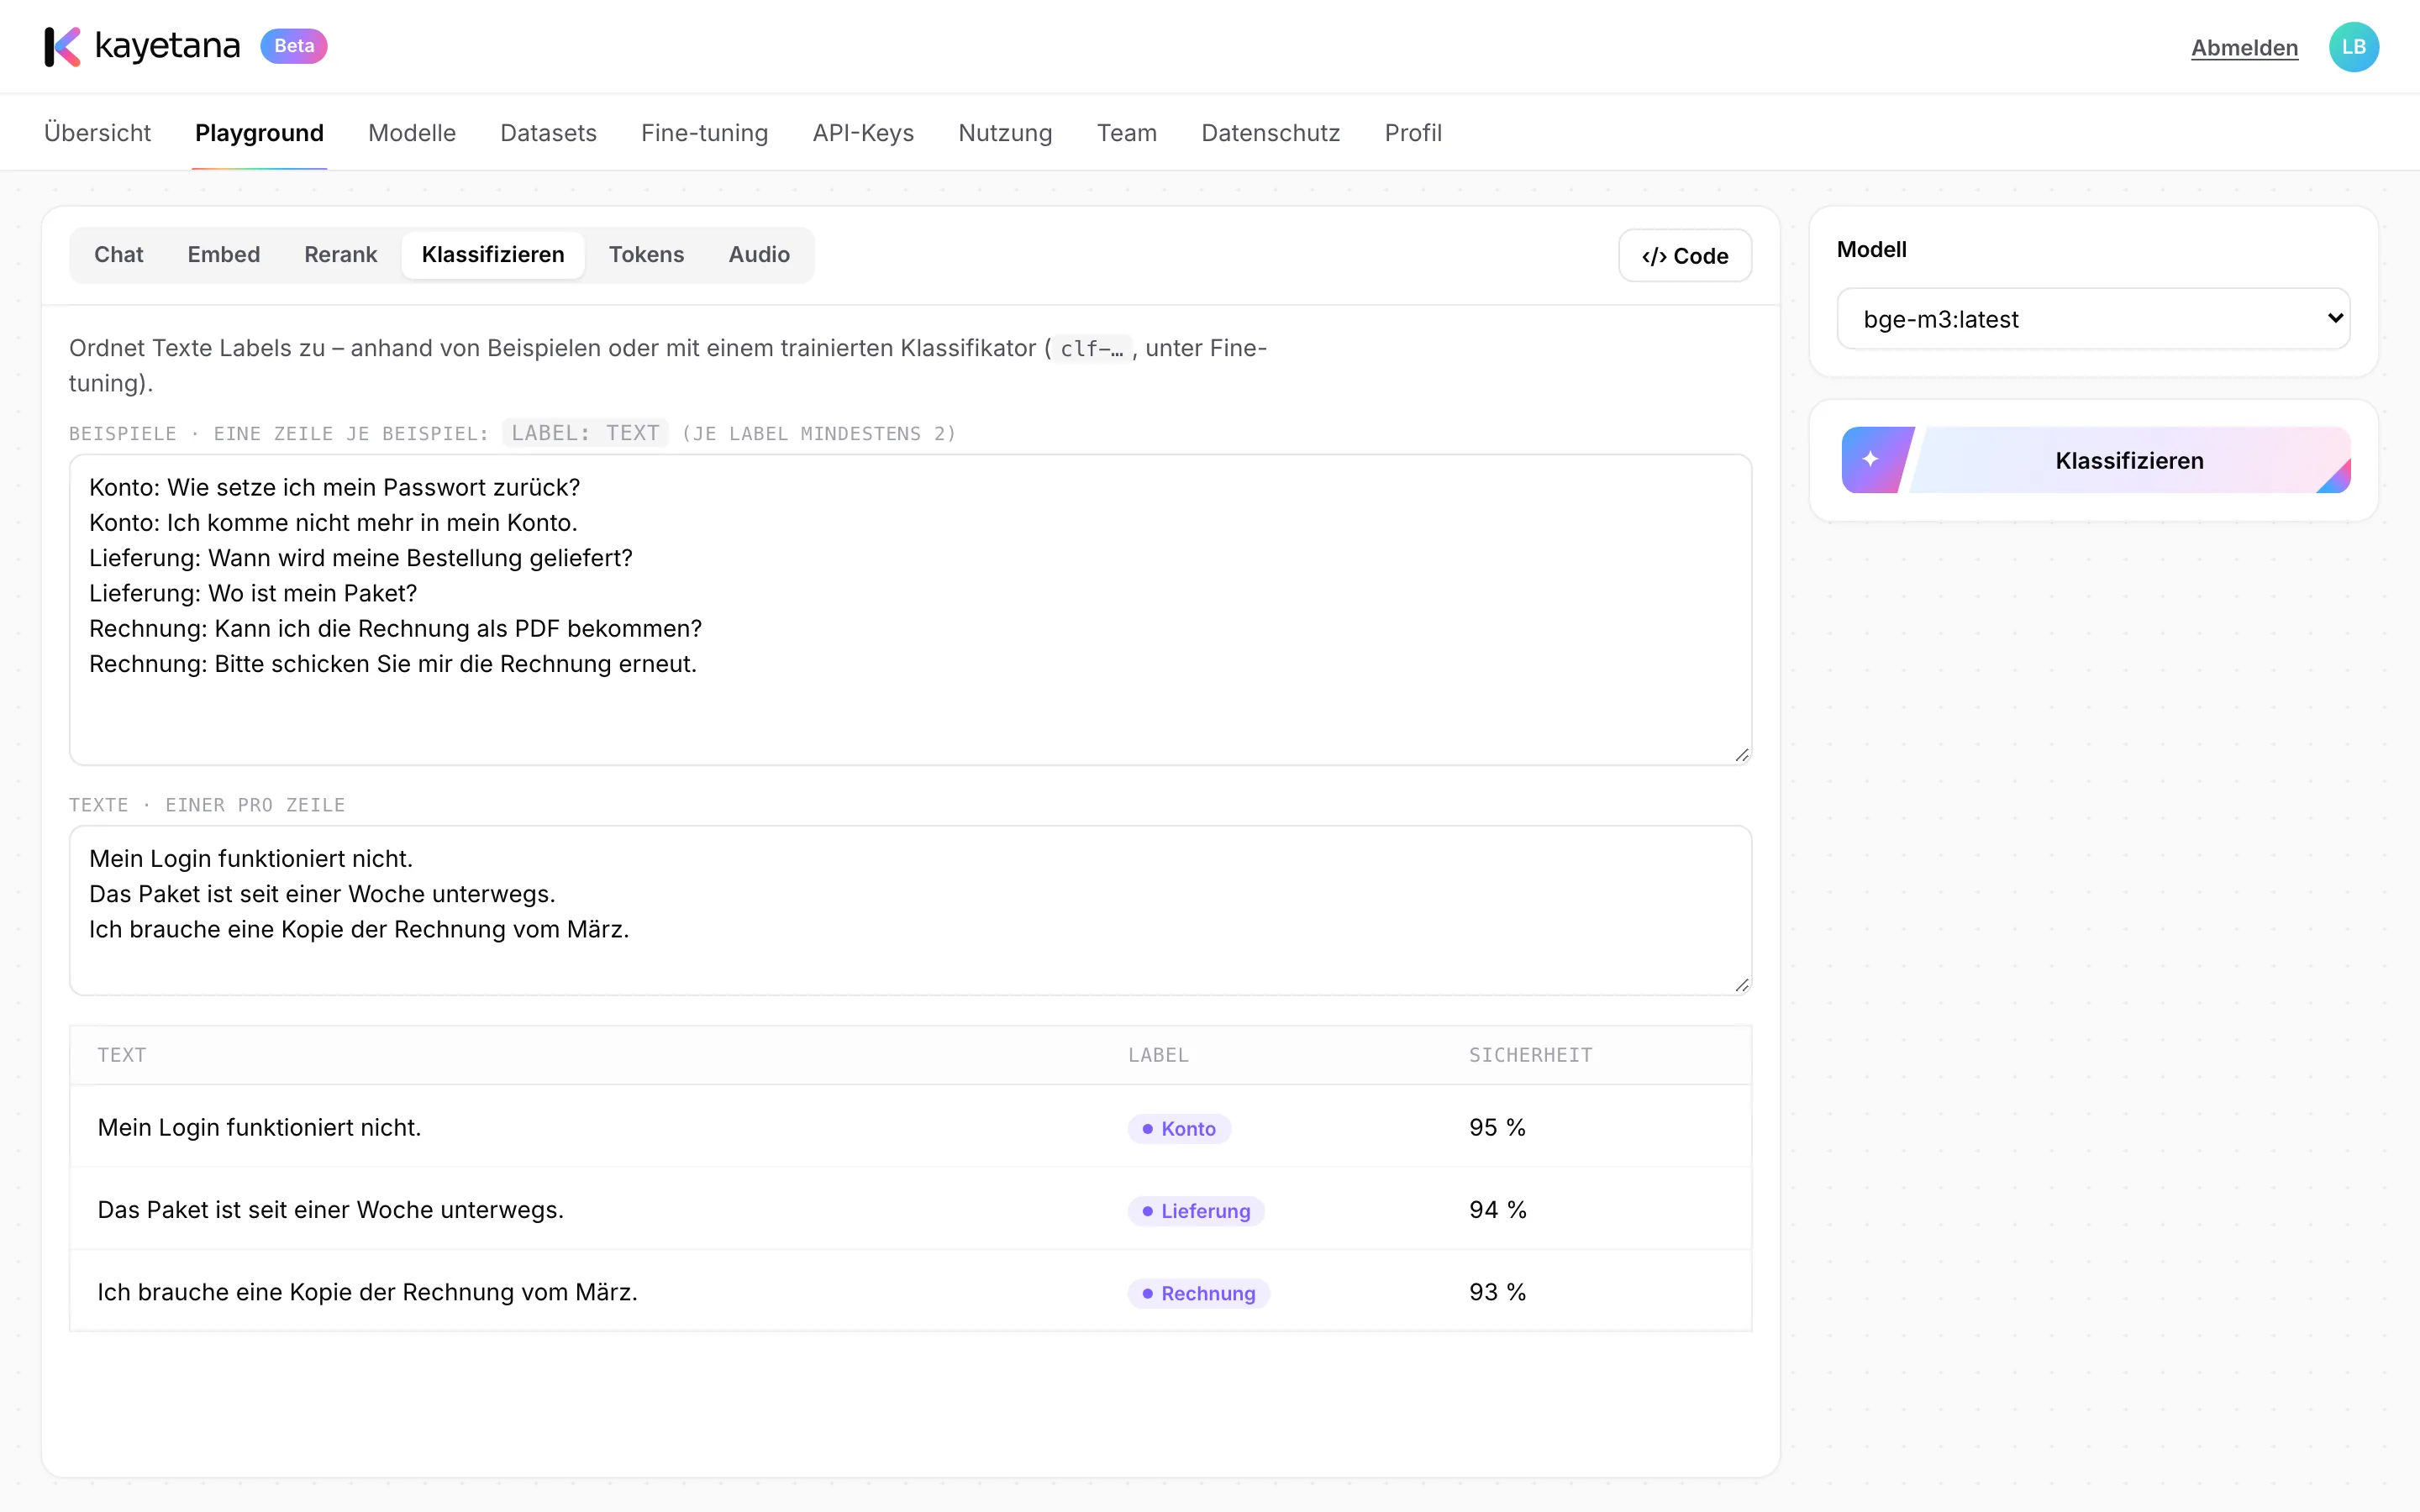
Beispiele rein, Labels raus.
Schreib zu jedem Label ein paar Beispiele, etwa für „Konto“, „Lieferung“ und „Rechnung“. Dann gibst du neue Texte ein. kayetana ordnet jeden Text einem Label zu und zeigt die Sicherheit in Prozent.
- Beispiele direkt im Aufruf
- Sicherheit je Label
- Ein oder mehrere Labels je Text
Mit Beispielen oder mit eigenem Klassifikator.
| Mit Beispielen | Trainierter Klassifikator | |
|---|---|---|
| Vorbereitung | Ein paar Beispiele je Label im Aufruf | Dataset mit Labels, einmal trainiert |
| Gut für | Schnelle Tests, wechselnde Kategorien | Feste Kategorien, viele Texte |
| Ein oder mehrere Labels je Text | ✓ | ✓ |
| Sicherheit je Label | ✓ | ✓ |
| Per API nutzbar | ✓ | ✓ |
Wo Klassifizieren Arbeit abnimmt.
Support-Tickets
Neue Tickets nach Thema sortieren und gleich an das richtige Team geben.
Posteingang
Mails an die Sammeladresse nach Anfrage, Bewerbung, Rechnung oder Beschwerde trennen.
Rückmeldungen
Kundenfeedback als positiv, neutral oder kritisch markieren.
Vertragsklauseln
Klauseln Themen wie Haftung, Laufzeit oder Datenschutz zuordnen.
Mehrere Themen
Eine Mail betrifft Lieferung und Rechnung? Mehrere Labels je Text sind möglich.
Prüfen, wo nötig
Die Sicherheit je Label zeigt, welche Fälle sich ein Mensch ansehen sollte.
So baust du deine eigene Sortierung.
Mit Beispielen testen
Im Playground prüfst du, ob sich deine Kategorien gut trennen lassen.
Dataset anlegen
Du lädst gelabelte Texte hoch, mit einem oder mehreren Labels je Text.
Klassifikator trainieren
Unter Fine-tuning baust du daraus einen Klassifikator „clf-name“ auf einem Embedding-Modell.
Per API nutzen
Deine Anwendung schickt Texte an classify und bekommt Labels und Sicherheit zurück.
Sortier deine Tickets automatisch.
Bring ein paar Beispiele aus deinem Posteingang mit. In der Demo siehst du das Ergebnis.
Häufige Fragen
Wie viele Beispiele brauche ich?
Für den Weg mit Beispielen reichen ein paar pro Label. Für einen eigenen Klassifikator legst du ein Dataset mit gelabelten Texten an.
Kann ein Text mehrere Labels bekommen?
Ja. Du kannst einen oder mehrere Labels je Text vergeben, und kayetana zeigt die Sicherheit für jedes Label.
Welches Modell steckt dahinter?
Klassifiziert wird mit einem Embedding-Modell, mitgeliefert ist bge-m3. Trainierte Klassifikatoren heißen „clf-name“ und bauen auf einem Embedding-Modell auf.
Wie binde ich das an unser Ticketsystem an?
Über den Endpunkt classify der REST-API. Dein System schickt die Texte und bekommt Labels und Sicherheit zurück.