 kayetana
Modelle, die deine Sprache sprechen.
Manche Aufgaben wiederholen sich jeden Tag. Mit Fine-tuning bringst du einem Modell bei, wie dein Team sie löst: mit eigenen Gesprächsbeispielen oder gelabelten Texten, direkt auf deinem Server.
Was du trainieren kannst.
Eigenes Chat-Modell
Du trainierst qwen3:4b-instruct per LoRA mit deinen Gesprächsbeispielen nach. Heraus kommt ein eigenes Modell „ft-name“.
Eigener Klassifikator
Aus einem Dataset mit Labels baust du einen Klassifikator „clf-name“ auf einem Embedding-Modell.
Bleibt im Haus
Trainingsdaten und fertige Modelle liegen auf deinem Server, nicht bei einem Cloud-Dienst.
So entsteht dein eigenes Chat-Modell.
Beispiele sammeln
Gute Gespräche aus dem Alltag, etwa Antworten des Kundenservice auf typische Rückfragen.
Dataset hochladen
Du lädst die Beispiele als Dataset vom Typ Chat-Fine-tuning hoch.
Training starten
kayetana trainiert qwen3:4b-instruct per LoRA nach.
Modell nutzen
Das neue Modell „ft-name“ steht im Playground und per API bereit.
Eigene Kategorien, fest trainiert.
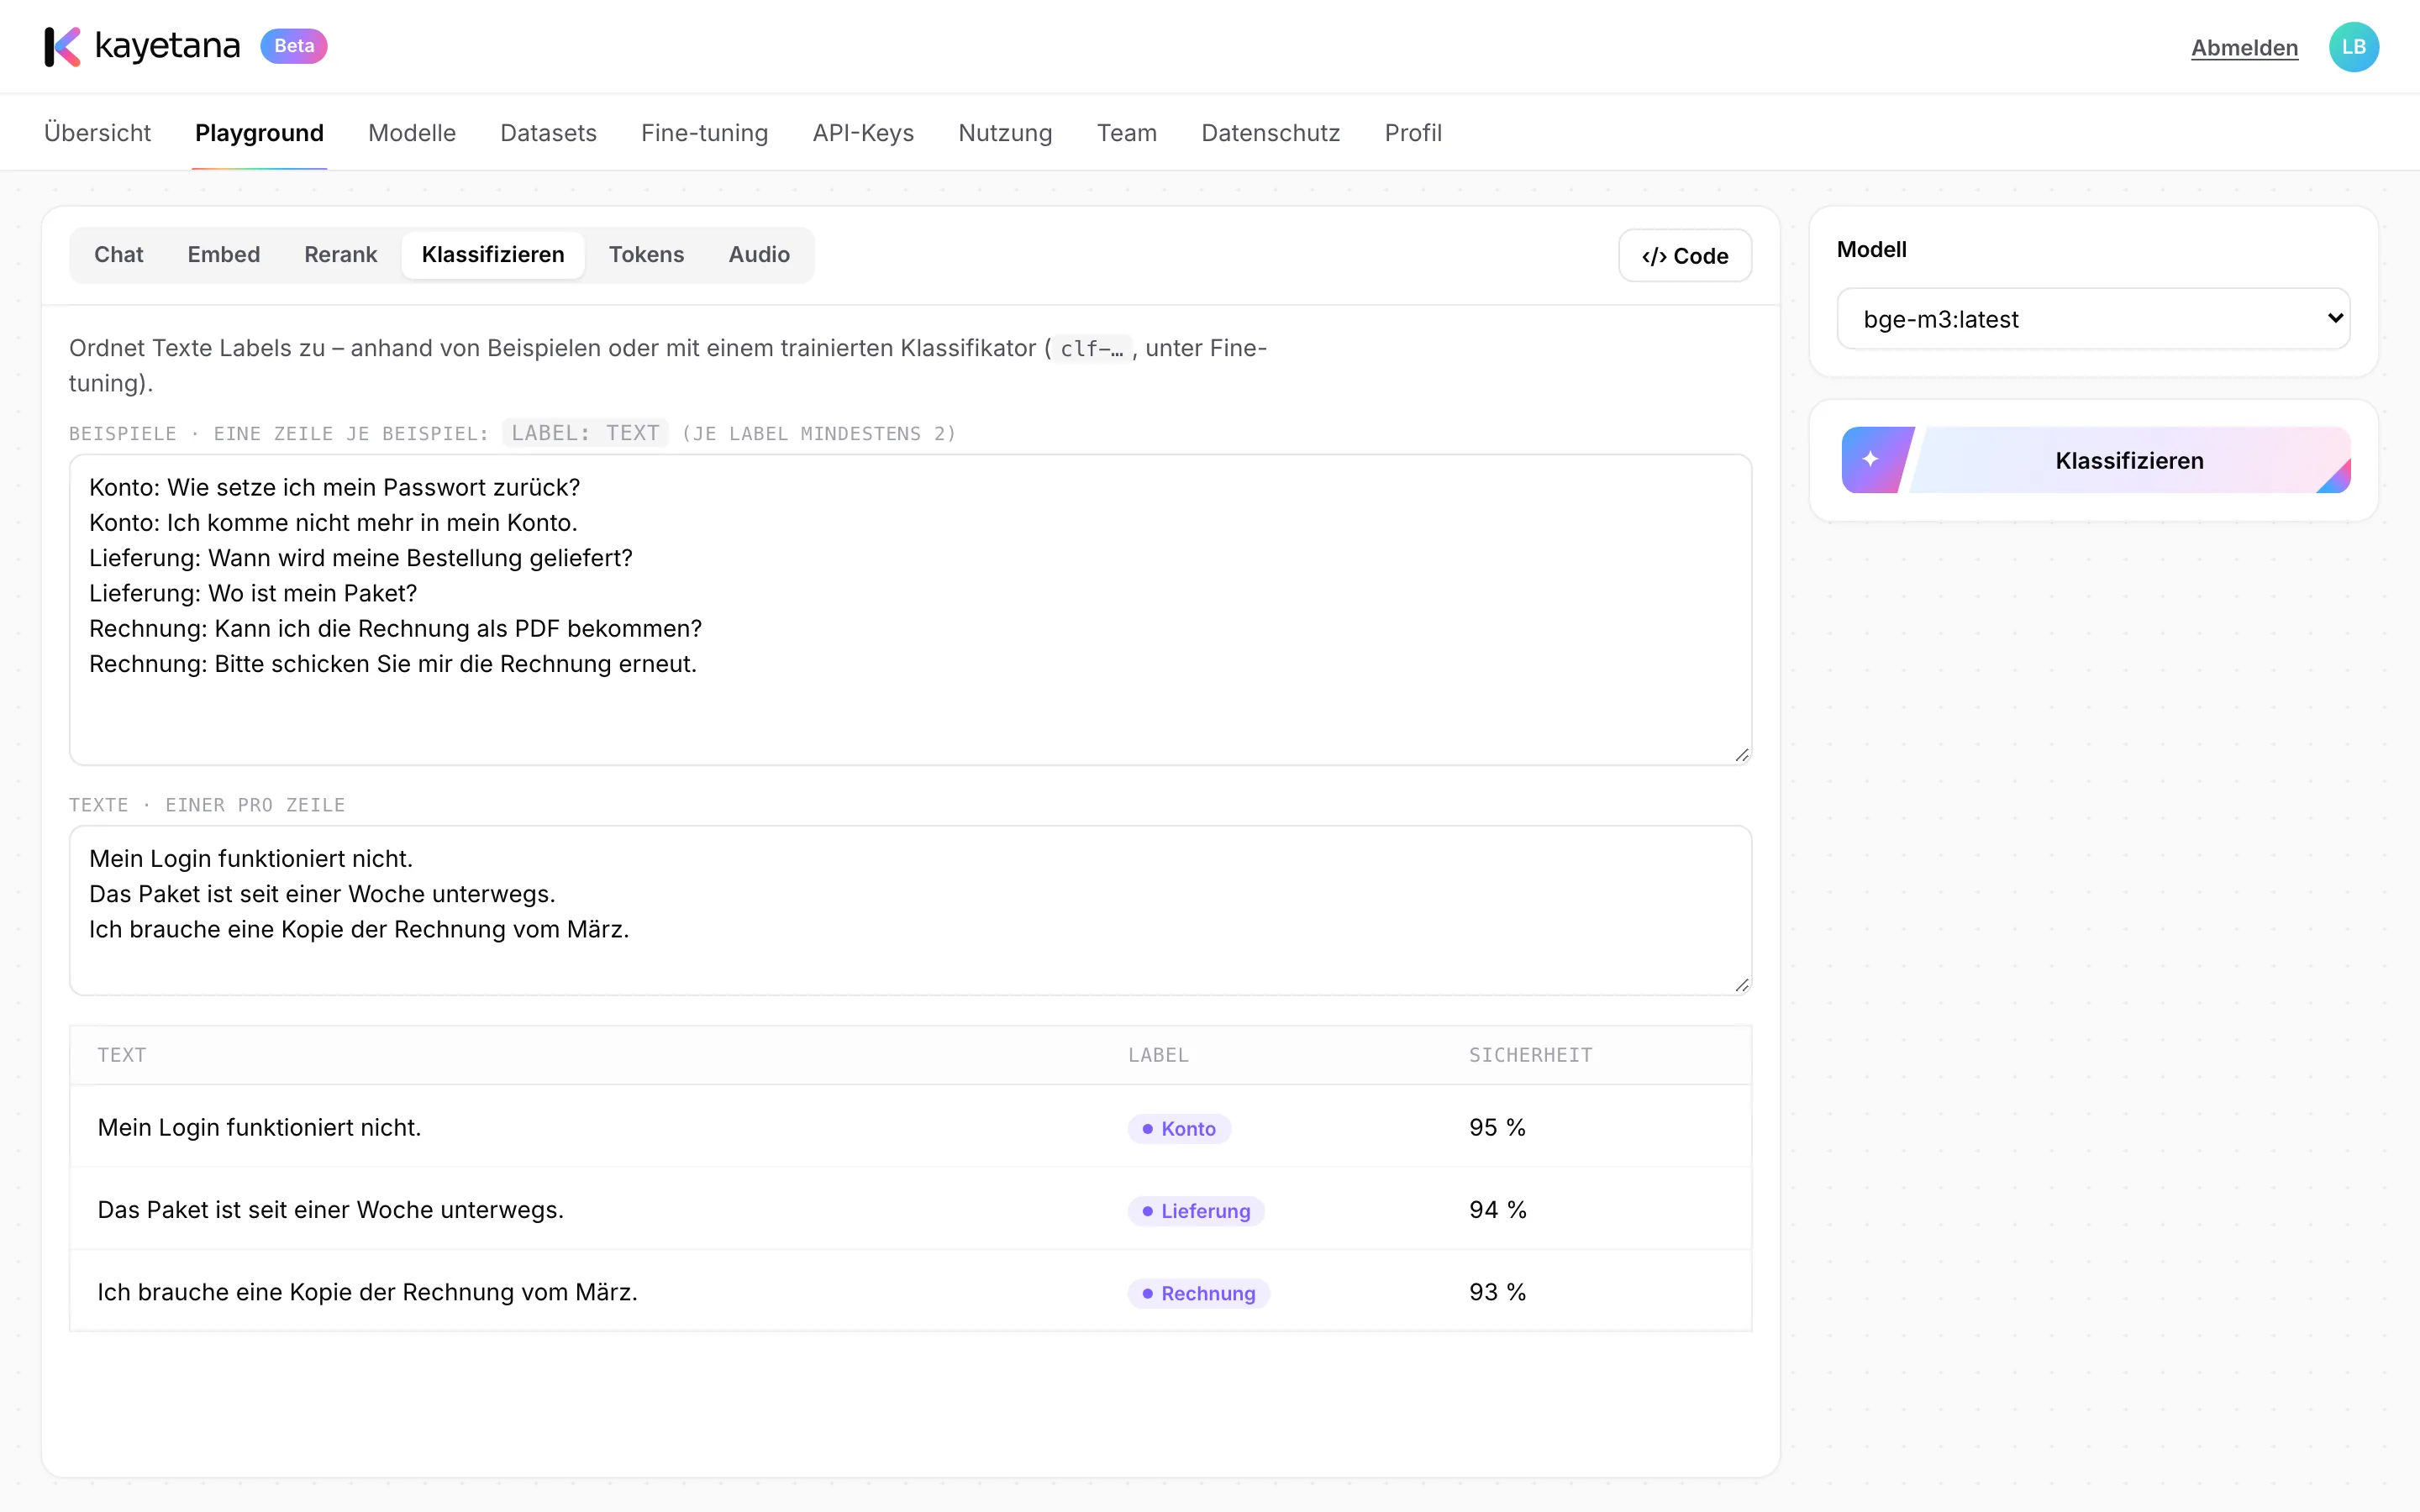
Wenn deine Kategorien feststehen, etwa die Themen deines Ticketsystems, lohnt sich ein eigener Klassifikator. Du trainierst ihn einmal aus einem gelabelten Dataset und nutzt ihn danach im Playground und über die API wie jeden anderen Klassifizierer.
- Ein oder mehrere Labels je Text
- Aufbauend auf einem Embedding-Modell
- Sicherheit je Label im Ergebnis
Chat-Modell oder Klassifikator?
| Chat-Fine-tuning | Klassifikator | |
|---|---|---|
| Ergebnis | Eigenes Modell „ft-name“ | Klassifikator „clf-name“ |
| Grundlage | qwen3:4b-instruct | Embedding-Modell |
| Trainingsdaten | Gesprächsbeispiele | Texte mit Labels |
| Typisch für | Ton, Aufbau und Inhalt von Antworten | Sortieren von Tickets und Mails |
Mach aus deinen Beispielen ein eigenes Modell.
Wir zeigen dir in einer Demo, wie Fine-tuning mit deinen Daten funktioniert.
Häufige Fragen
Welches Modell kann ich nachtrainieren?
Derzeit qwen3:4b-instruct, per LoRA. Klassifikatoren baust du auf einem Embedding-Modell.
Welche Daten brauche ich?
Für ein Chat-Modell Gesprächsbeispiele als Dataset vom Typ Chat-Fine-tuning. Für einen Klassifikator Texte mit einem oder mehreren Labels.
Wo liegen meine Trainingsdaten?
Auf deinem Server. Für Datasets legst du auf der Datenschutz-Seite eine Aufbewahrungsfrist fest, danach werden sie automatisch gelöscht.
Wie nutze ich das fertige Modell?
Es erscheint als „ft-name“ bzw. „clf-name“ und steht im Playground und über die REST-API bereit.