 kayetana
Suchen nach Bedeutung, nicht nach Stichworten.
Embed wandelt Texte in Vektoren um, Rerank sortiert Dokumente nach Relevanz zu einer Frage. So findest du die passende Stelle, auch wenn sie andere Worte benutzt als deine Suche.
Was du für deine Suche bekommst.
Embed
Texte in Vektoren umwandeln, in den Formaten float, int8, uint8, binary und ubinary.
Rerank
Dokumente nach Relevanz zu einer Frage sortieren, über die Ähnlichkeit der Embeddings mit bge-m3.
2D-Darstellung
Im Playground siehst du Embeddings als Punkte auf einer Fläche. Ähnliche Texte liegen nah beieinander.
bge-m3 für Embed und Rerank, schon eingerichtet.
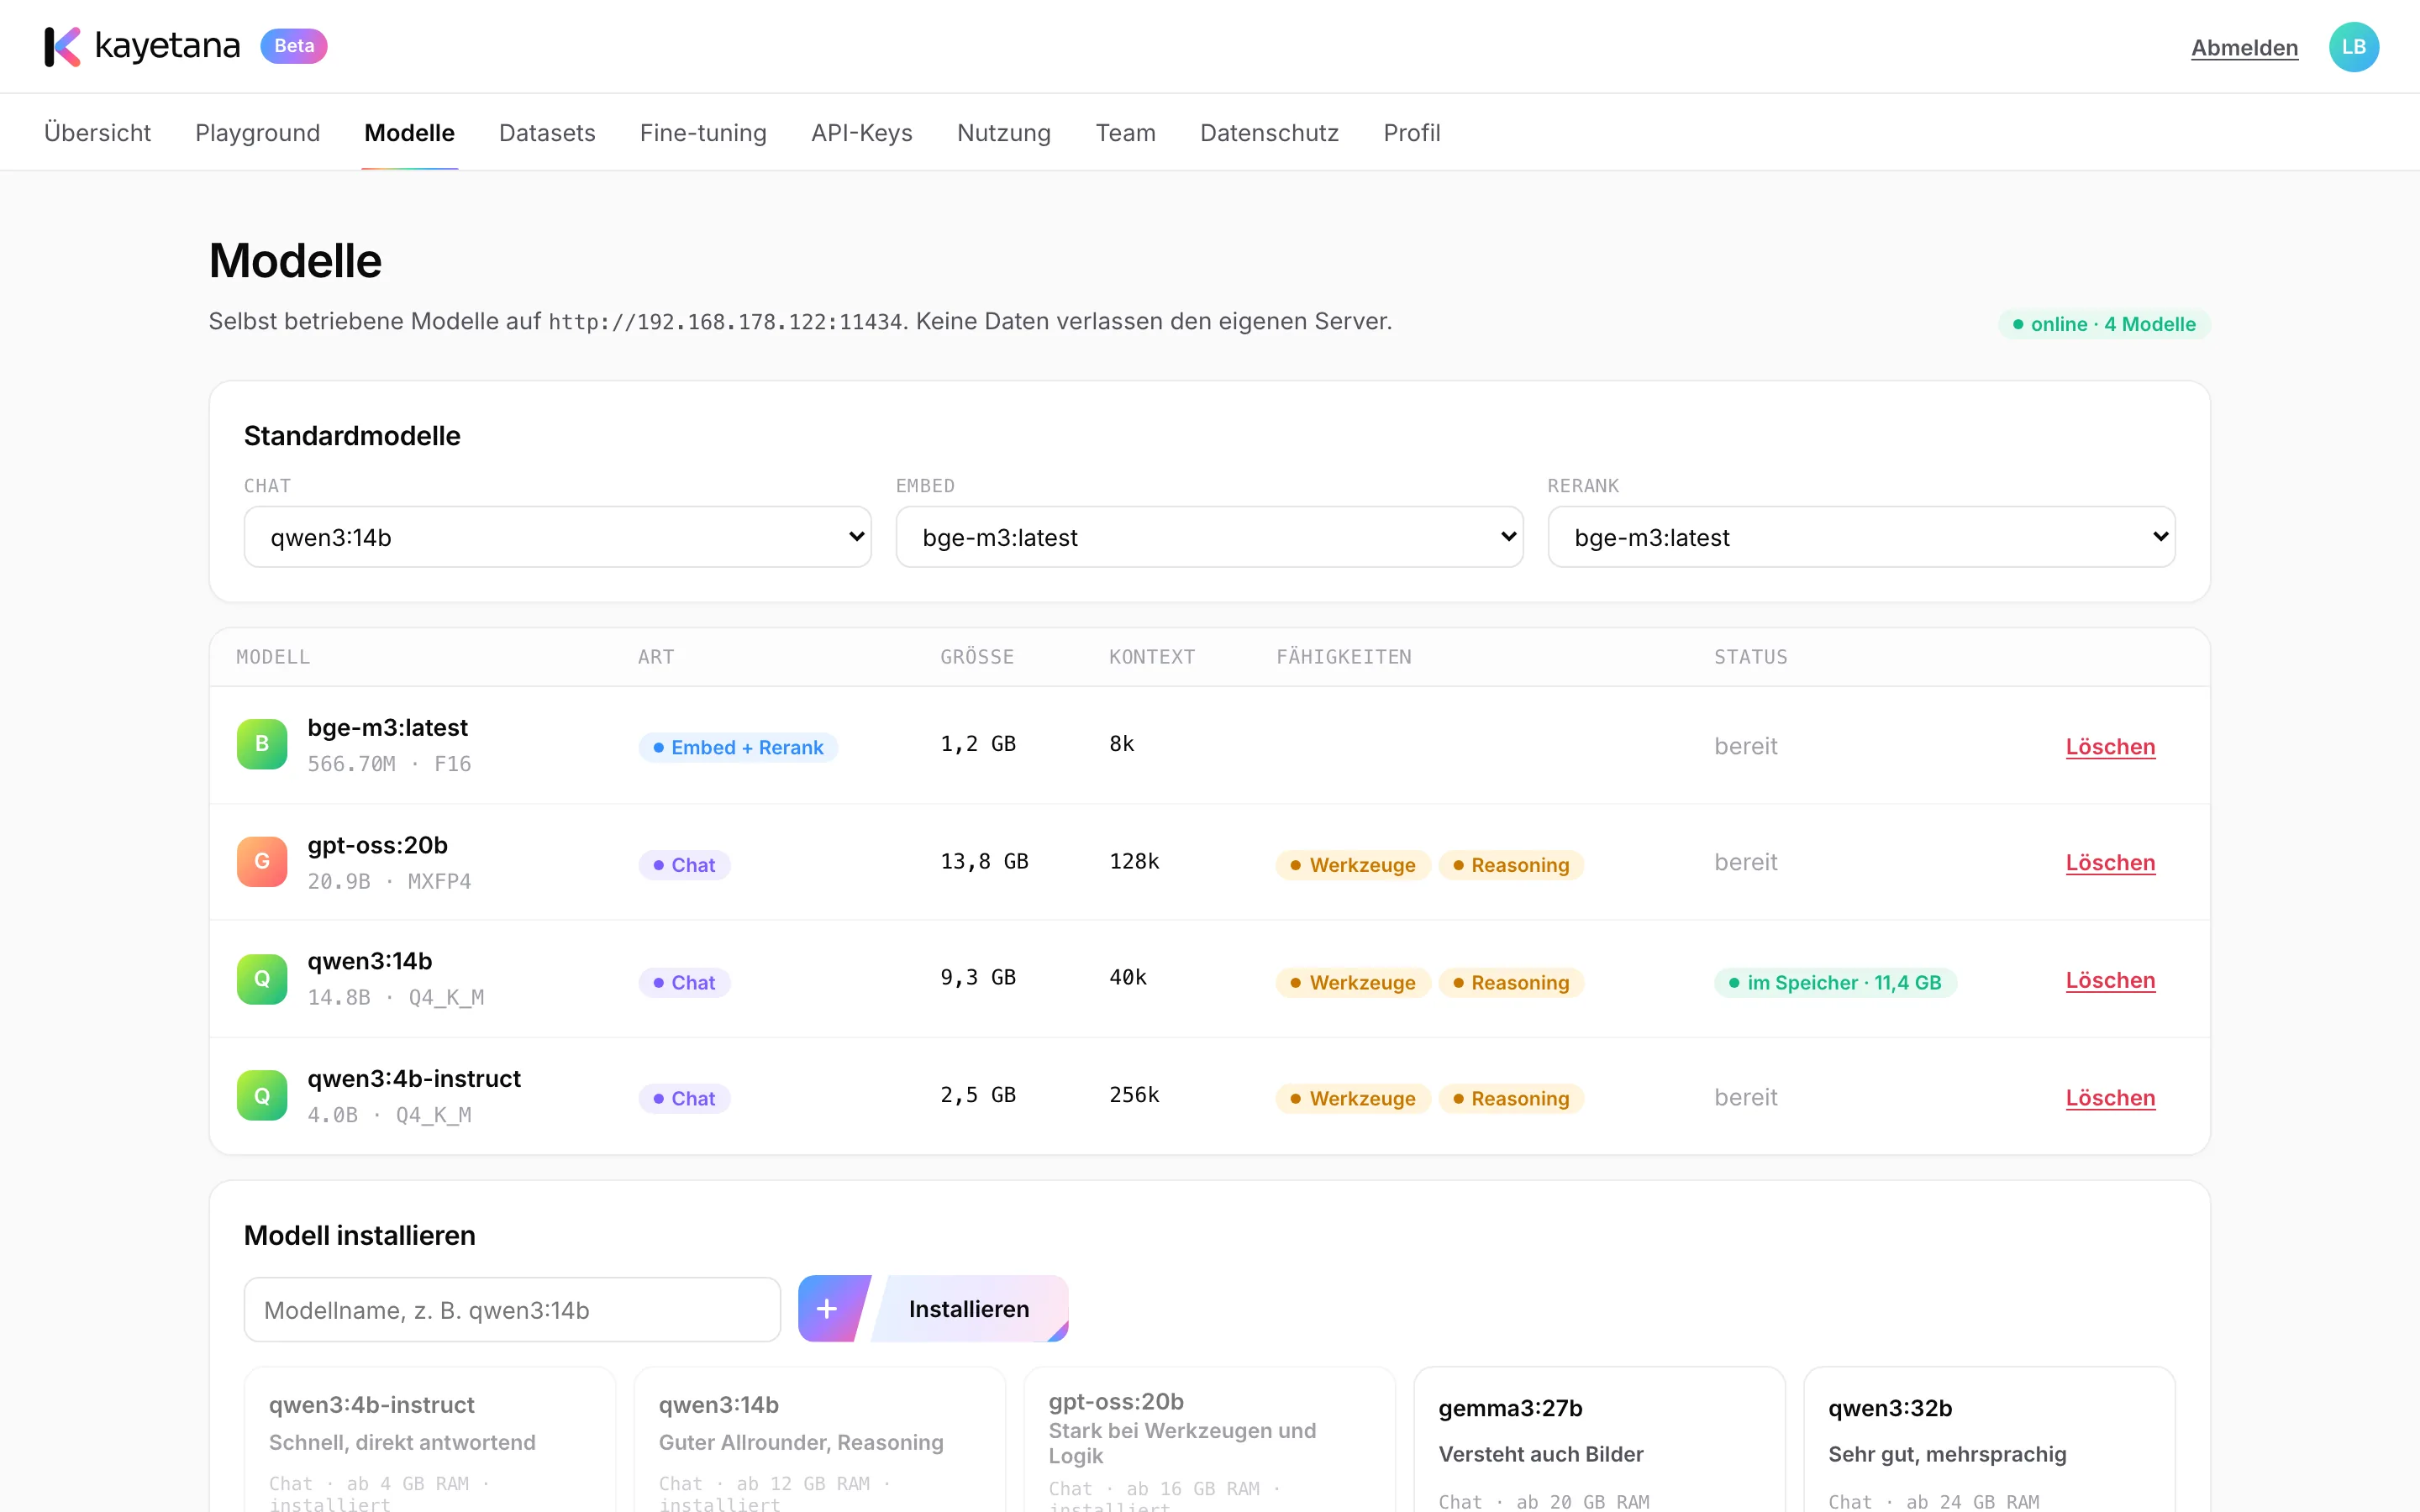
In der Modellverwaltung legst du fest, welches Modell standardmäßig für Embed und Rerank arbeitet. Mitgeliefert ist bge-m3. Weitere offene Modelle lädst du bei Bedarf nach.
- Standardmodell je Aufgabe
- Größe und Kontextlänge auf einen Blick
- Weitere Modelle per Name nachladen
Eine Suche über deine Hilfeartikel.
Bestand einbetten
Du lädst deine Hilfeartikel als Dataset hoch und bettest sie per Embed-Job im Hintergrund ein. Das Ergebnis bekommst du als JSONL.
Frage einbetten
Die Suchanfrage aus einem Support-Ticket wird mit demselben Modell in einen Vektor umgewandelt.
Treffer finden
Deine Anwendung vergleicht die Vektoren und holt die ähnlichsten Artikel.
Neu sortieren
Rerank ordnet die Treffer nach Relevanz zur Frage, bevor du sie anzeigst.
Wofür sich Suche nach Bedeutung lohnt.
- Passende Hilfeartikel zu Support-Tickets finden
- Ähnliche Verträge und Klauseln aufspüren
- Doppelte Anfragen erkennen
- Textbausteine für Angebote vorschlagen
- Interne Wissenssammlungen durchsuchbar machen
- Dokumente vor einer Antwort mit Quellen vorsortieren
Finde, was in deinen Texten steckt.
Wir zeigen dir in einer Demo, wie Embed und Rerank mit deinen eigenen Inhalten arbeiten.
Häufige Fragen
Was ist der Unterschied zwischen Embed und Rerank?
Embed wandelt einzelne Texte in Vektoren um, die du speichern und vergleichen kannst. Rerank bekommt eine Frage und mehrere Dokumente und sortiert sie nach Relevanz.
Nutzt Rerank einen Cross-Encoder?
Nein. Rerank sortiert über die Ähnlichkeit der Embeddings mit bge-m3.
Welche Vektorformate gibt es?
float, int8, uint8, binary und ubinary. So wählst du zwischen voller Genauigkeit und kompakteren Vektoren.
Wie bette ich große Bestände ein?
Mit einem Embed-Job. Du lädst ein Dataset hoch, kayetana bettet es im Hintergrund ein, zeigt den Fortschritt und stellt das Ergebnis als JSONL zum Download bereit.