 kayetana
Deine KI-Schnittstelle. Auf deiner Hardware.
Software- und IT-Dienstleister bauen KI in Produkte, Support und interne Werkzeuge. kayetana liefert dafür eine REST-API mit eigenen Keys, Limits und Nutzungsübersicht, ohne Abrechnung pro Token.
Was du mit kayetana baust.
Suche in der Doku
Produktdokumentation einbetten, mit Rerank sortieren und Antworten mit citations ausliefern.
Ticket-Routing
Supporttickets per Classify Kategorien zuordnen, mit Konfidenz je Label.
Assistenten im Produkt
Chat mit Streaming, JSON-Modus und Function Calling in eigene Oberflächen einbauen.
Sprachfunktionen
Aufnahmen per transcribe in Text umwandeln, mit Zeitmarken.
Eigene Modelle
Chat-Modelle per LoRA nachtrainieren und Klassifikatoren aus Datasets bauen.
Kosten im Griff
Monatslimit je Key, Nutzung pro Tag, Key und Modell, Antwortzeit und Fehlerquote.
Eine Schnittstelle für alle Aufgaben.
Unter /v2 findest du chat, embed, rerank, classify, tokenize, detokenize, transcribe, parse, models, datasets, embed-jobs und finetuning. Authentifizierung per Bearer-Key, Streaming per Server-Sent Events.
- Beispielcode in Python, TypeScript und curl
- Monatslimit je Key, bei Überschreitung 429
- Embeddings als float, int8, uint8, binary, ubinary
Kundendaten deiner Kunden bleiben bei dir.
Wenn du KI für Kunden betreibst, trägst du Verantwortung für deren Daten. Mit kayetana bleiben Daten auf deinem Server und du behältst die Kontrolle.
- Kein Prompt geht an einen Cloud-Dienst
- Feste Kosten statt Abrechnung pro Token
- Offene Modelle, Standardmodell je Aufgabe
- Prompts und Antworten werden nie gespeichert
- Betrieb ohne Internet möglich
- Updates per Skript
Vom Playground in den Code.
Im Playground testen
Prompt, Modell und Parameter ausprobieren.
Code übernehmen
Fertigen Beispielcode in Python, TypeScript oder curl kopieren.
Key anlegen
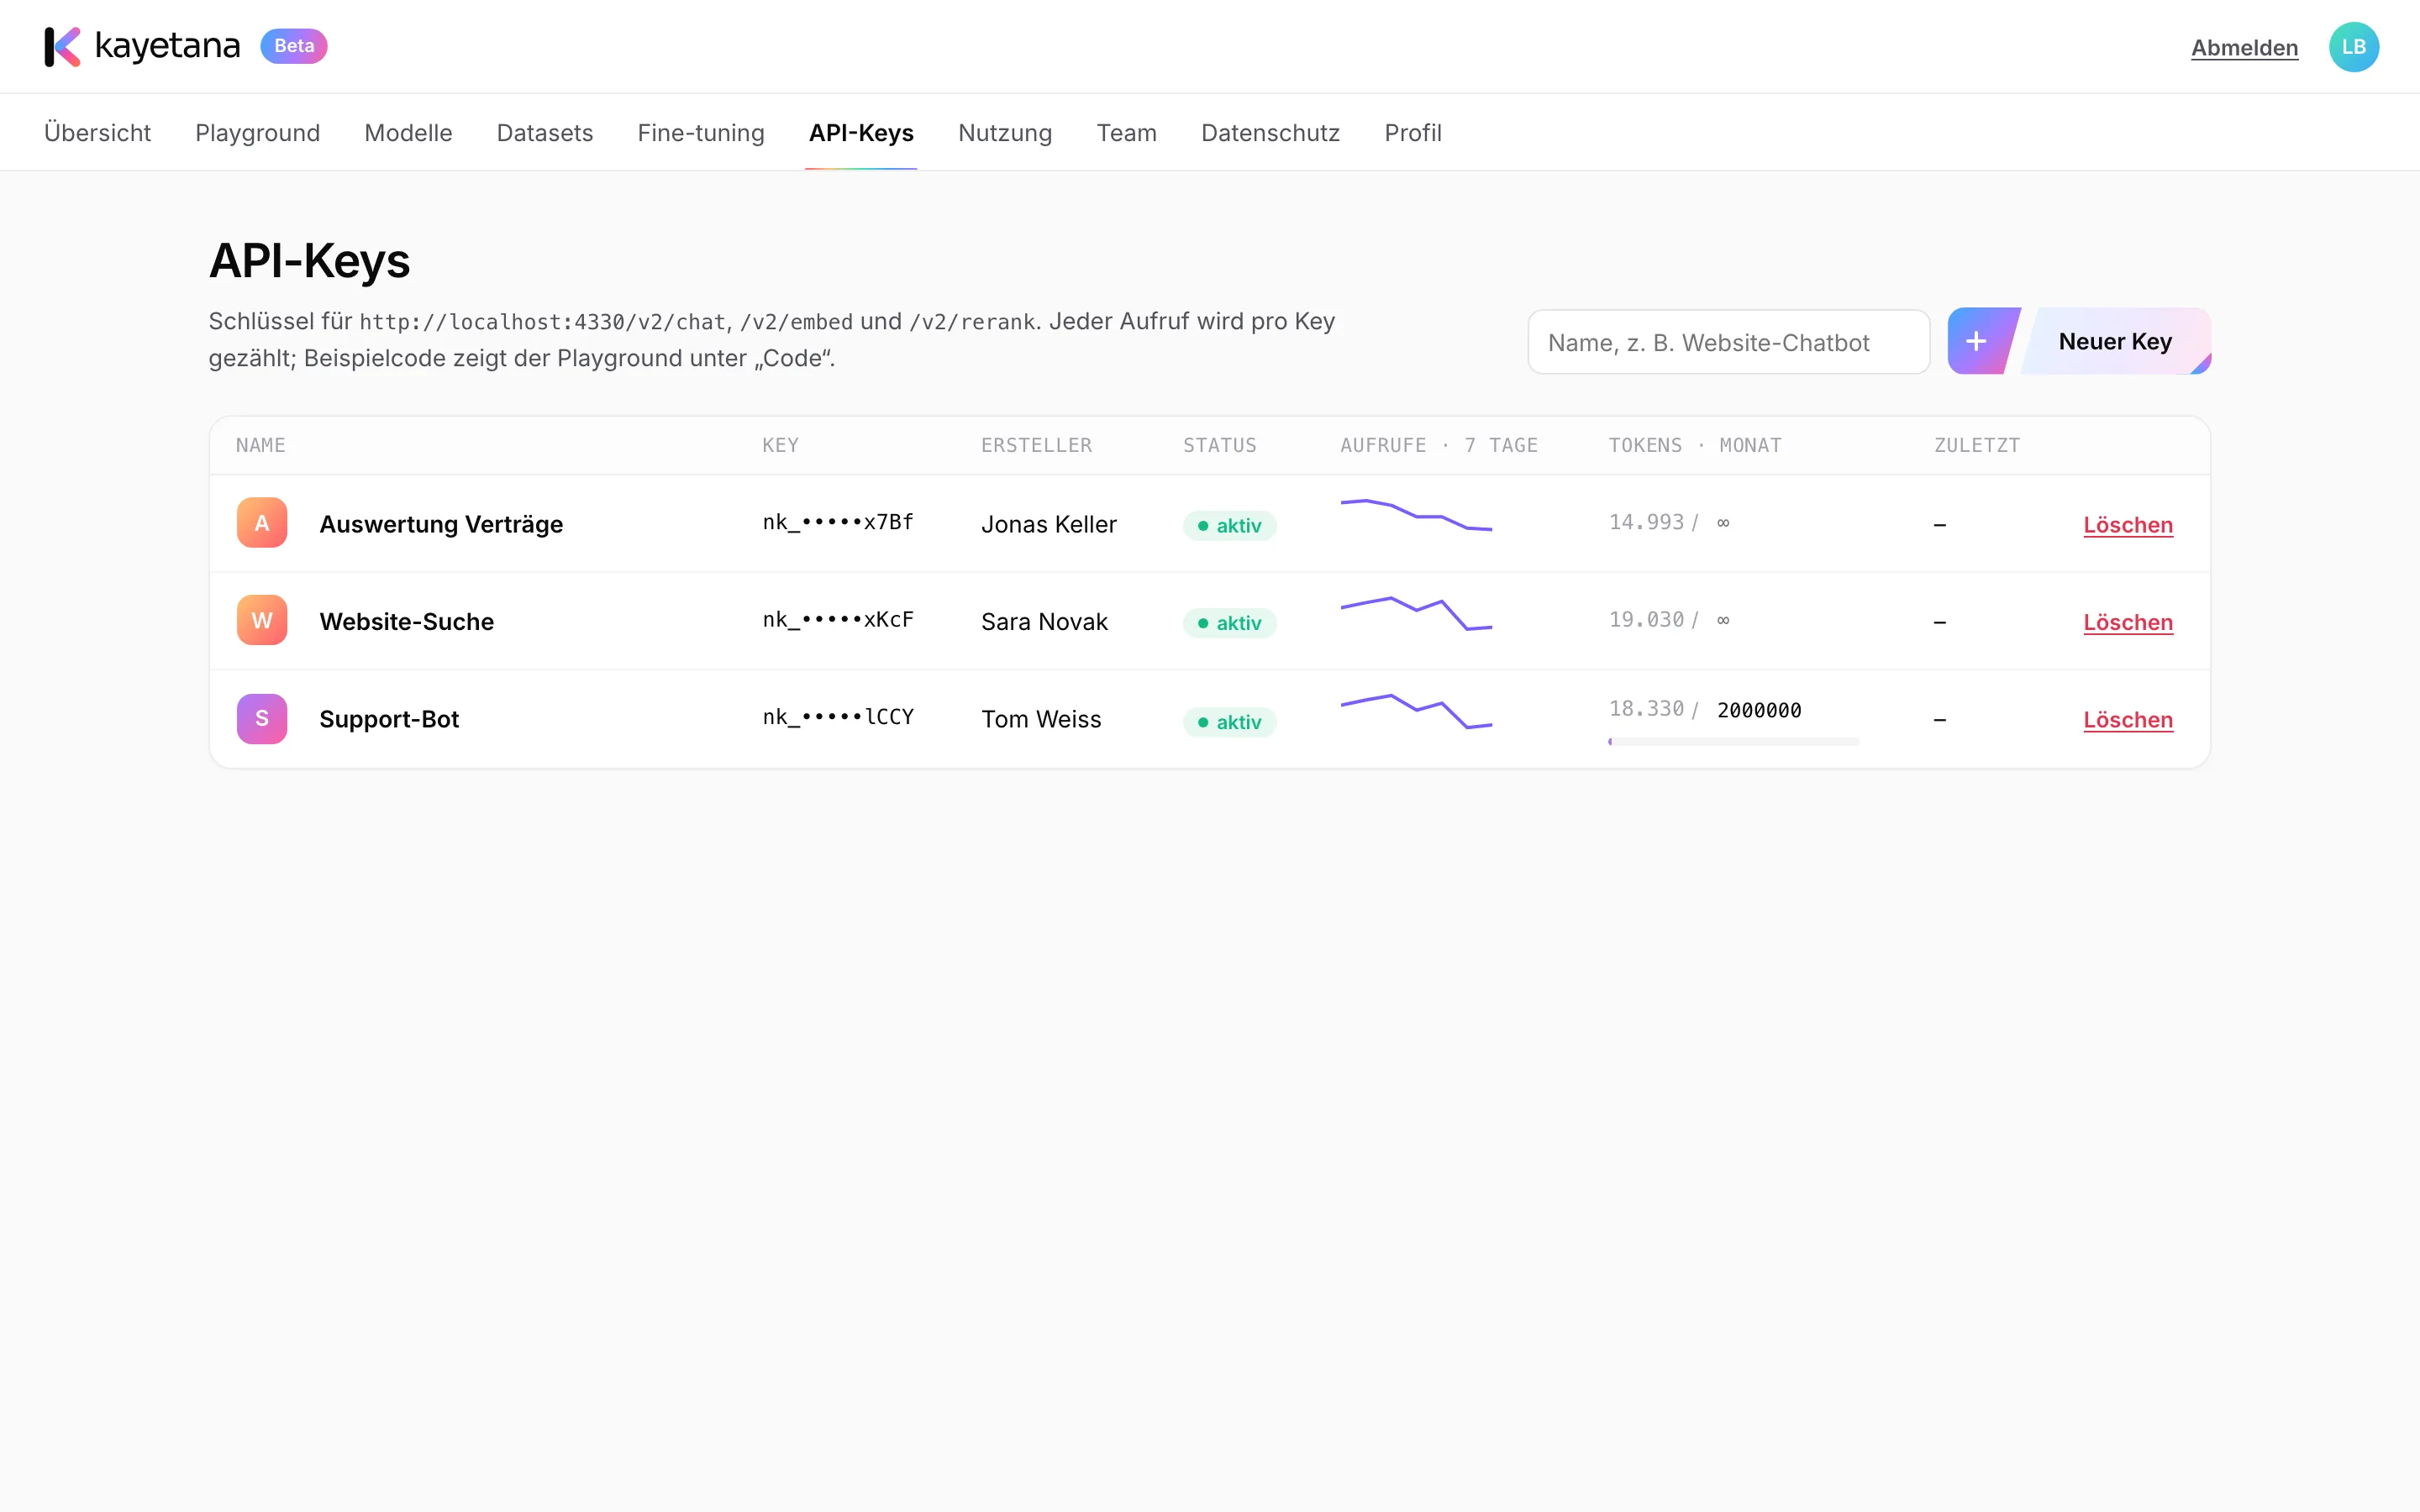
Einen API-Key mit Monatslimit für deine Anwendung erzeugen.
Sieh dir die API live an.
In der Demo bauen wir einen Aufruf vom Playground bis in deinen Code.
Häufige Fragen
Kann ich kayetana für mehrere Kunden nutzen?
Du kannst je Anwendung oder Kunde einen eigenen API-Key mit Monatslimit anlegen und die Nutzung je Key auswerten.
Wie funktioniert Rerank?
Rerank sortiert Dokumente nach Relevanz zu einer Frage über die Embedding-Ähnlichkeit mit bge-m3. Es ist kein Cross-Encoder.
Welche Modelle kann ich nutzen?
Mitgeliefert sind qwen3:4b-instruct, qwen3:14b, gpt-oss:20b, bge-m3 und Whisper large-v3-turbo. Weitere offene Modelle lädst du per Name aus der Ollama-Bibliothek.
Gibt es Streaming?
Ja. Chat streamt per Server-Sent Events, auch bei Antworten mit Quellen.