 kayetana
Eine Plattform für alles, was dein Team mit KI macht.
kayetana läuft auf einem Mac Studio in deinem Netz. Im Browser testest du Modelle, per API gibst du sie für eigene Anwendungen frei, und die Nutzung hast du jederzeit im Blick. Prompts und Antworten werden nie gespeichert.
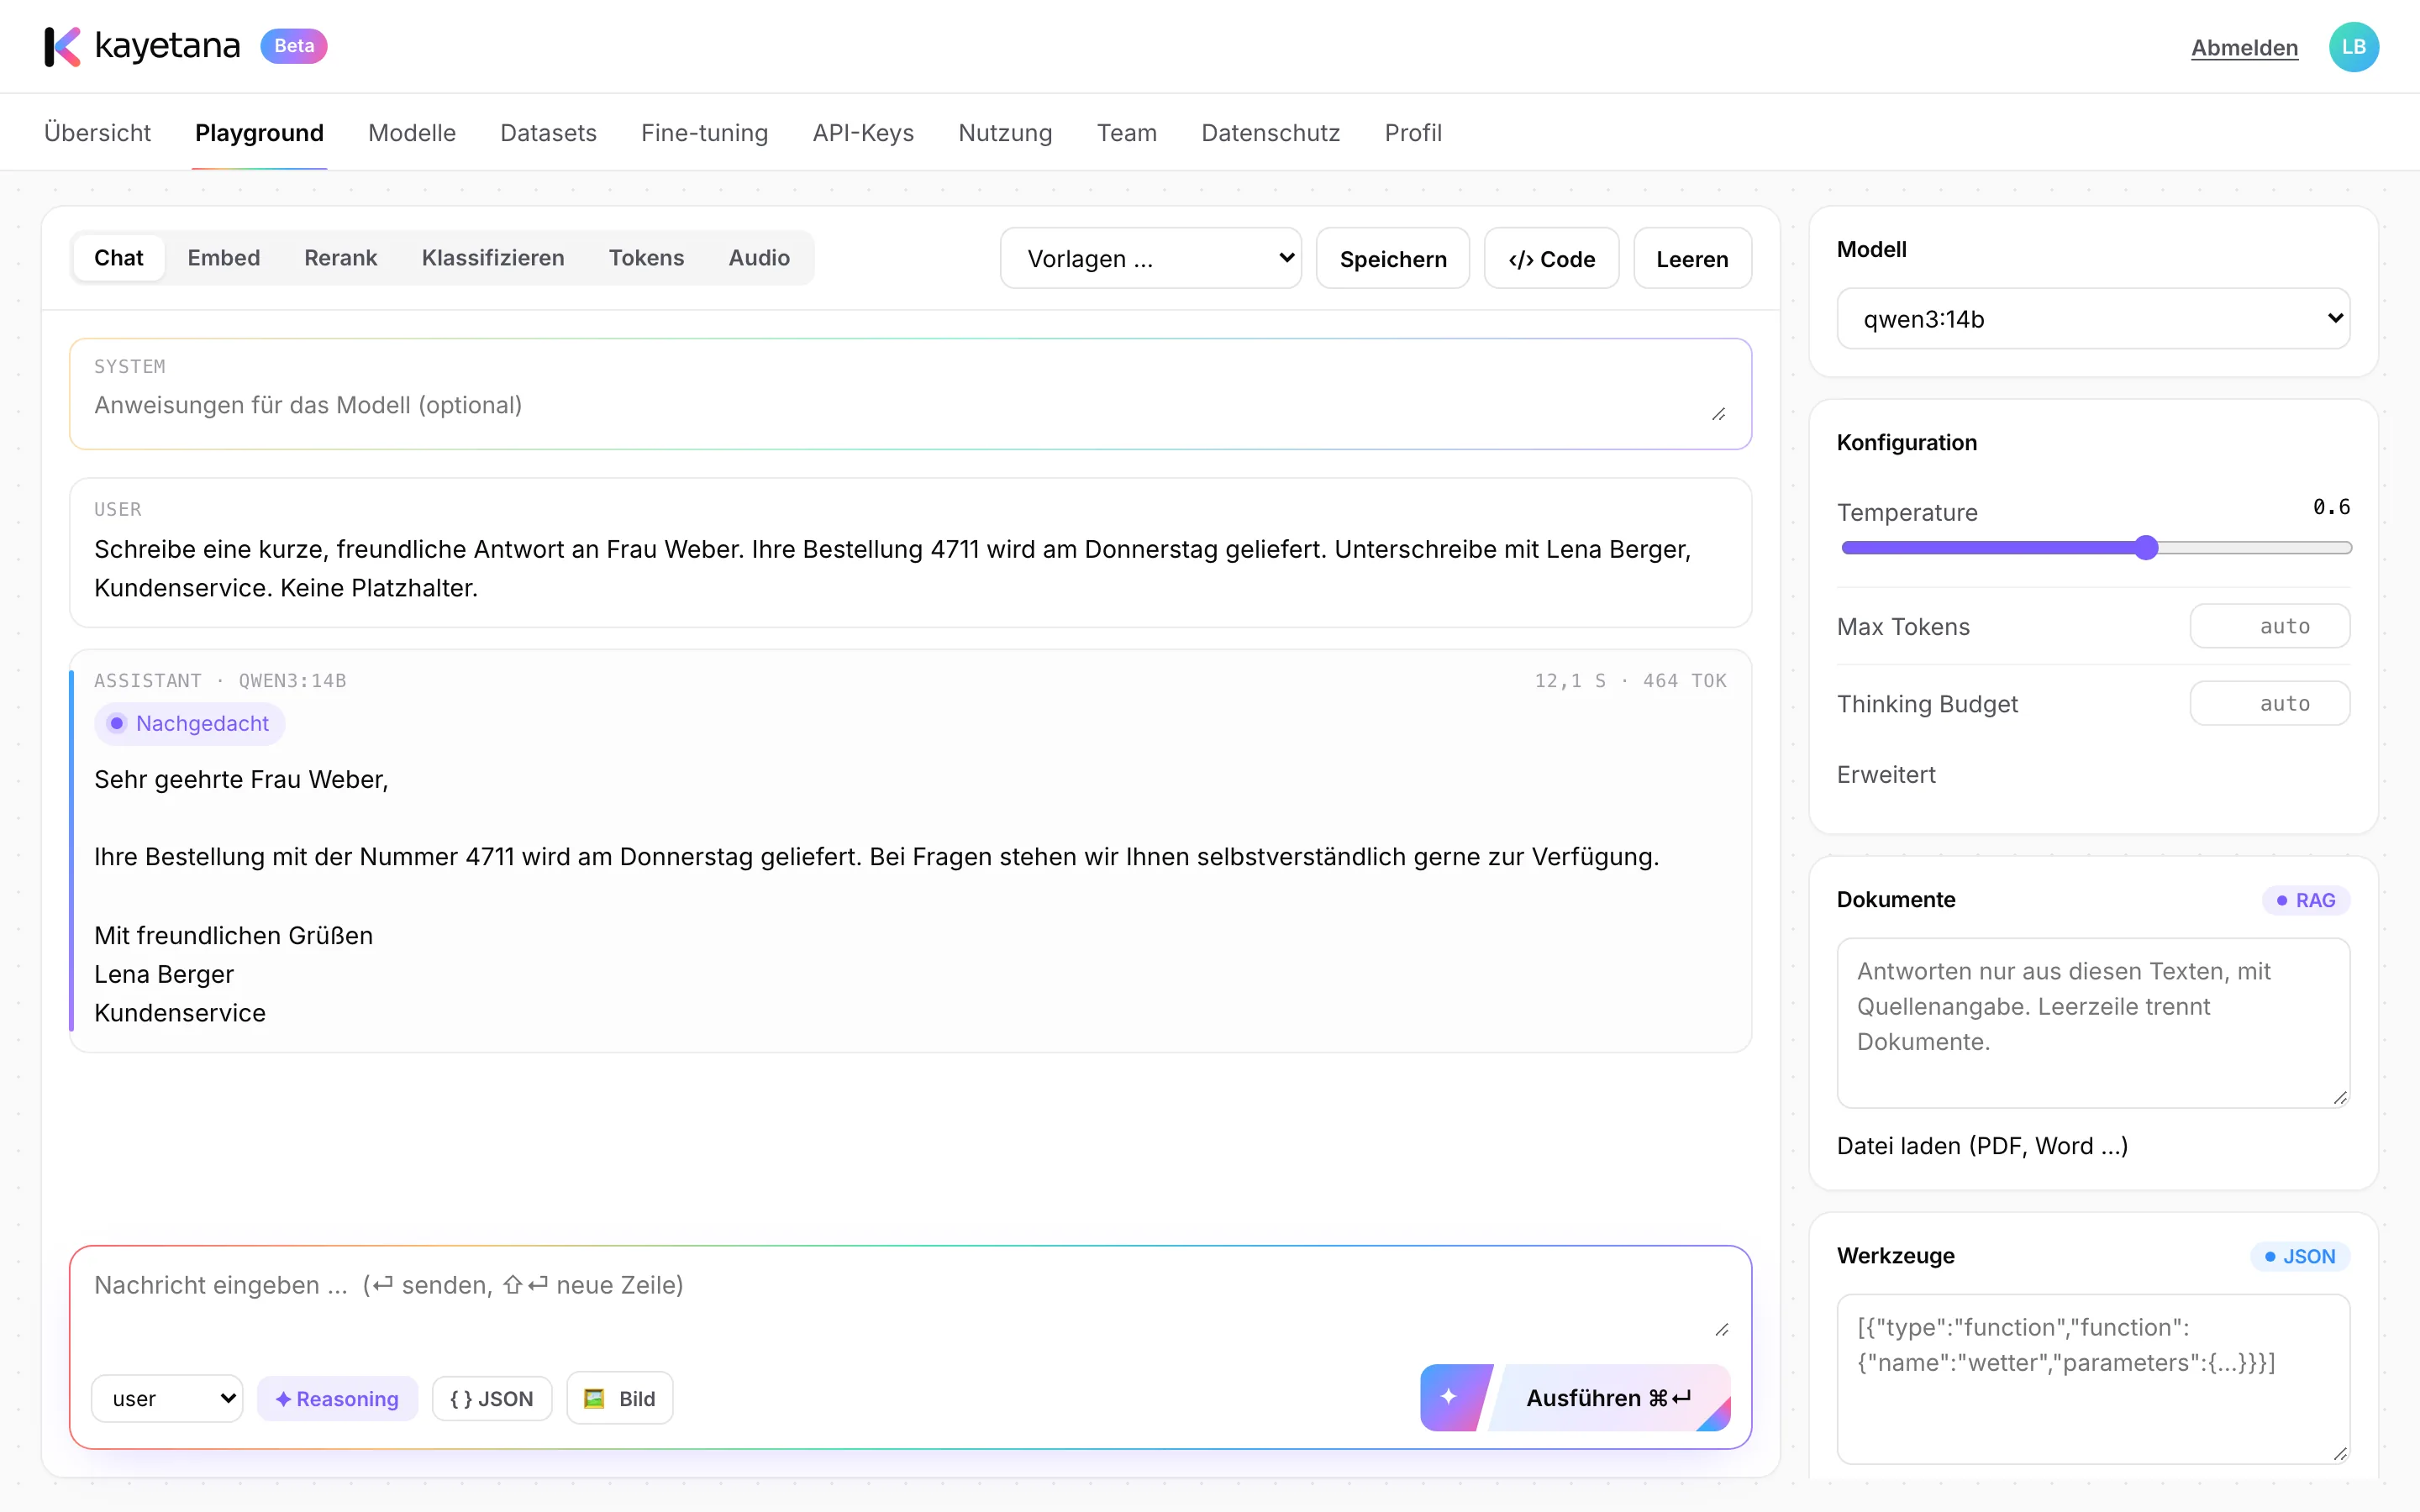
Modelle im Browser testen: Systemanweisung, Reasoning, JSON, Bilder, Werkzeuge und fertiger Code.
Mehr erfahren →Antworten aus DokumentenFragen an Richtlinien, Verträge und Handbücher stellen. Jede Aussage zeigt ihre Quelle.
Mehr erfahren →Suche: Embed & RerankTexte in Vektoren umwandeln und nach Relevanz sortieren: die Basis für Suche nach Bedeutung.
Mehr erfahren →KlassifizierenTickets und Mails automatisch Kategorien zuordnen, mit Beispielen oder eigenem Klassifikator.
Mehr erfahren →Audio & TranskriptionBesprechungen und Sprachnachrichten in Text umwandeln, mit Zeitmarken. Bis 100 MB pro Datei.
Mehr erfahren →ModelleOffene Modelle für Chat, Reasoning, Suche und Sprache. Neue laden, Standards je Aufgabe festlegen.
Mehr erfahren →Fine-tuningEin Chat-Modell mit eigenen Beispielen nachtrainieren oder einen eigenen Klassifikator bauen.
Mehr erfahren →Datasets & Embed-JobsCSV, JSONL, TXT, PDF und Word hochladen und ganze Bestände im Hintergrund einbetten.
Mehr erfahren →REST-APIAlle Funktionen über eine REST-API, mit API-Keys, Monatslimit je Key und fertigem Beispielcode.
Mehr erfahren →Team & NutzungRollen für Owner, Admins und Member, Einladung per Link und volle Übersicht über die Nutzung.
Mehr erfahren →Die Werkzeuge, die dein Team jeden Tag braucht.
Alles läuft auf deinem eigenen Server und ist im Browser sofort ausprobierbar.
Chat & Playground
Modelle direkt im Browser testen: mit Systemanweisung, Reasoning, JSON-Modus und Bildern als Eingabe.
Antworten aus Dokumenten
Richtlinien, Verträge und Handbücher hochladen. Jede Aussage nennt die Quelle, aus der sie stammt.
Suche mit Embed & Rerank
Texte in Vektoren umwandeln und nach Relevanz sortieren. Die Grundlage für eine Suche, die Bedeutung versteht.
Klassifizieren
Support-Tickets und Mails automatisch Kategorien zuordnen, mit Beispielen oder einem eigenen Klassifikator.
Audio
Besprechungen und Sprachnachrichten in Text umwandeln, mit Zeitmarken. Bis 100 MB pro Datei.
Modelle
Offene Modelle für Chat, Reasoning, Suche und Sprache. Neue laden, Standards festlegen.
Eigene Modelle, eigene Anwendungen, klare Regeln.
Fine-tuning
Ein Chat-Modell mit deinen Gesprächsbeispielen nachtrainieren oder aus gelabelten Daten einen Klassifikator bauen.
Datasets & Embed-Jobs
CSV, JSONL, TXT, PDF und Word hochladen und ganze Bestände im Hintergrund einbetten.
REST-API
Alle Funktionen über eine Schnittstelle, mit API-Keys und Monatslimit je Key.
Team & Nutzung
Rollen für Owner, Admins und Member. Tokens und Aufrufe pro Tag, Key und Modell.
Sicherheit & Datenschutz
Keine Inhalte gespeichert, eigene Aufbewahrungsfristen, HTTPS im eigenen Netz.
Offline betriebsfähig
Nach dem einmaligen Laden der Modelle läuft der Betrieb ohne Internet.
Ausprobieren, bevor du etwas baust.
Im Playground liegen Chat, Embed, Rerank, Klassifizieren, Tokens und Audio nebeneinander. Du siehst sofort, wie ein Modell auf deine Frage antwortet. Die Einstellungen übernimmst du als fertigen Code in Python, TypeScript oder curl.
- Vorlagen für das ganze Team speichern
- Fertiger Code zu jeder Anfrage
- Modell und Einstellungen je Aufgabe wählen
Vom Test im Browser bis zur eigenen Anwendung.
Ausprobieren
Im Playground testest du Modelle mit echten Beispielen aus deinem Alltag, etwa einer Frage zur Reiserichtlinie.
Freigeben
Für eigene Anwendungen legst du API-Keys an, jeweils mit eigenem Monatslimit.
Anpassen
Mit Datasets und Fine-tuning machst du Modelle passender für deine Aufgaben.
Im Blick behalten
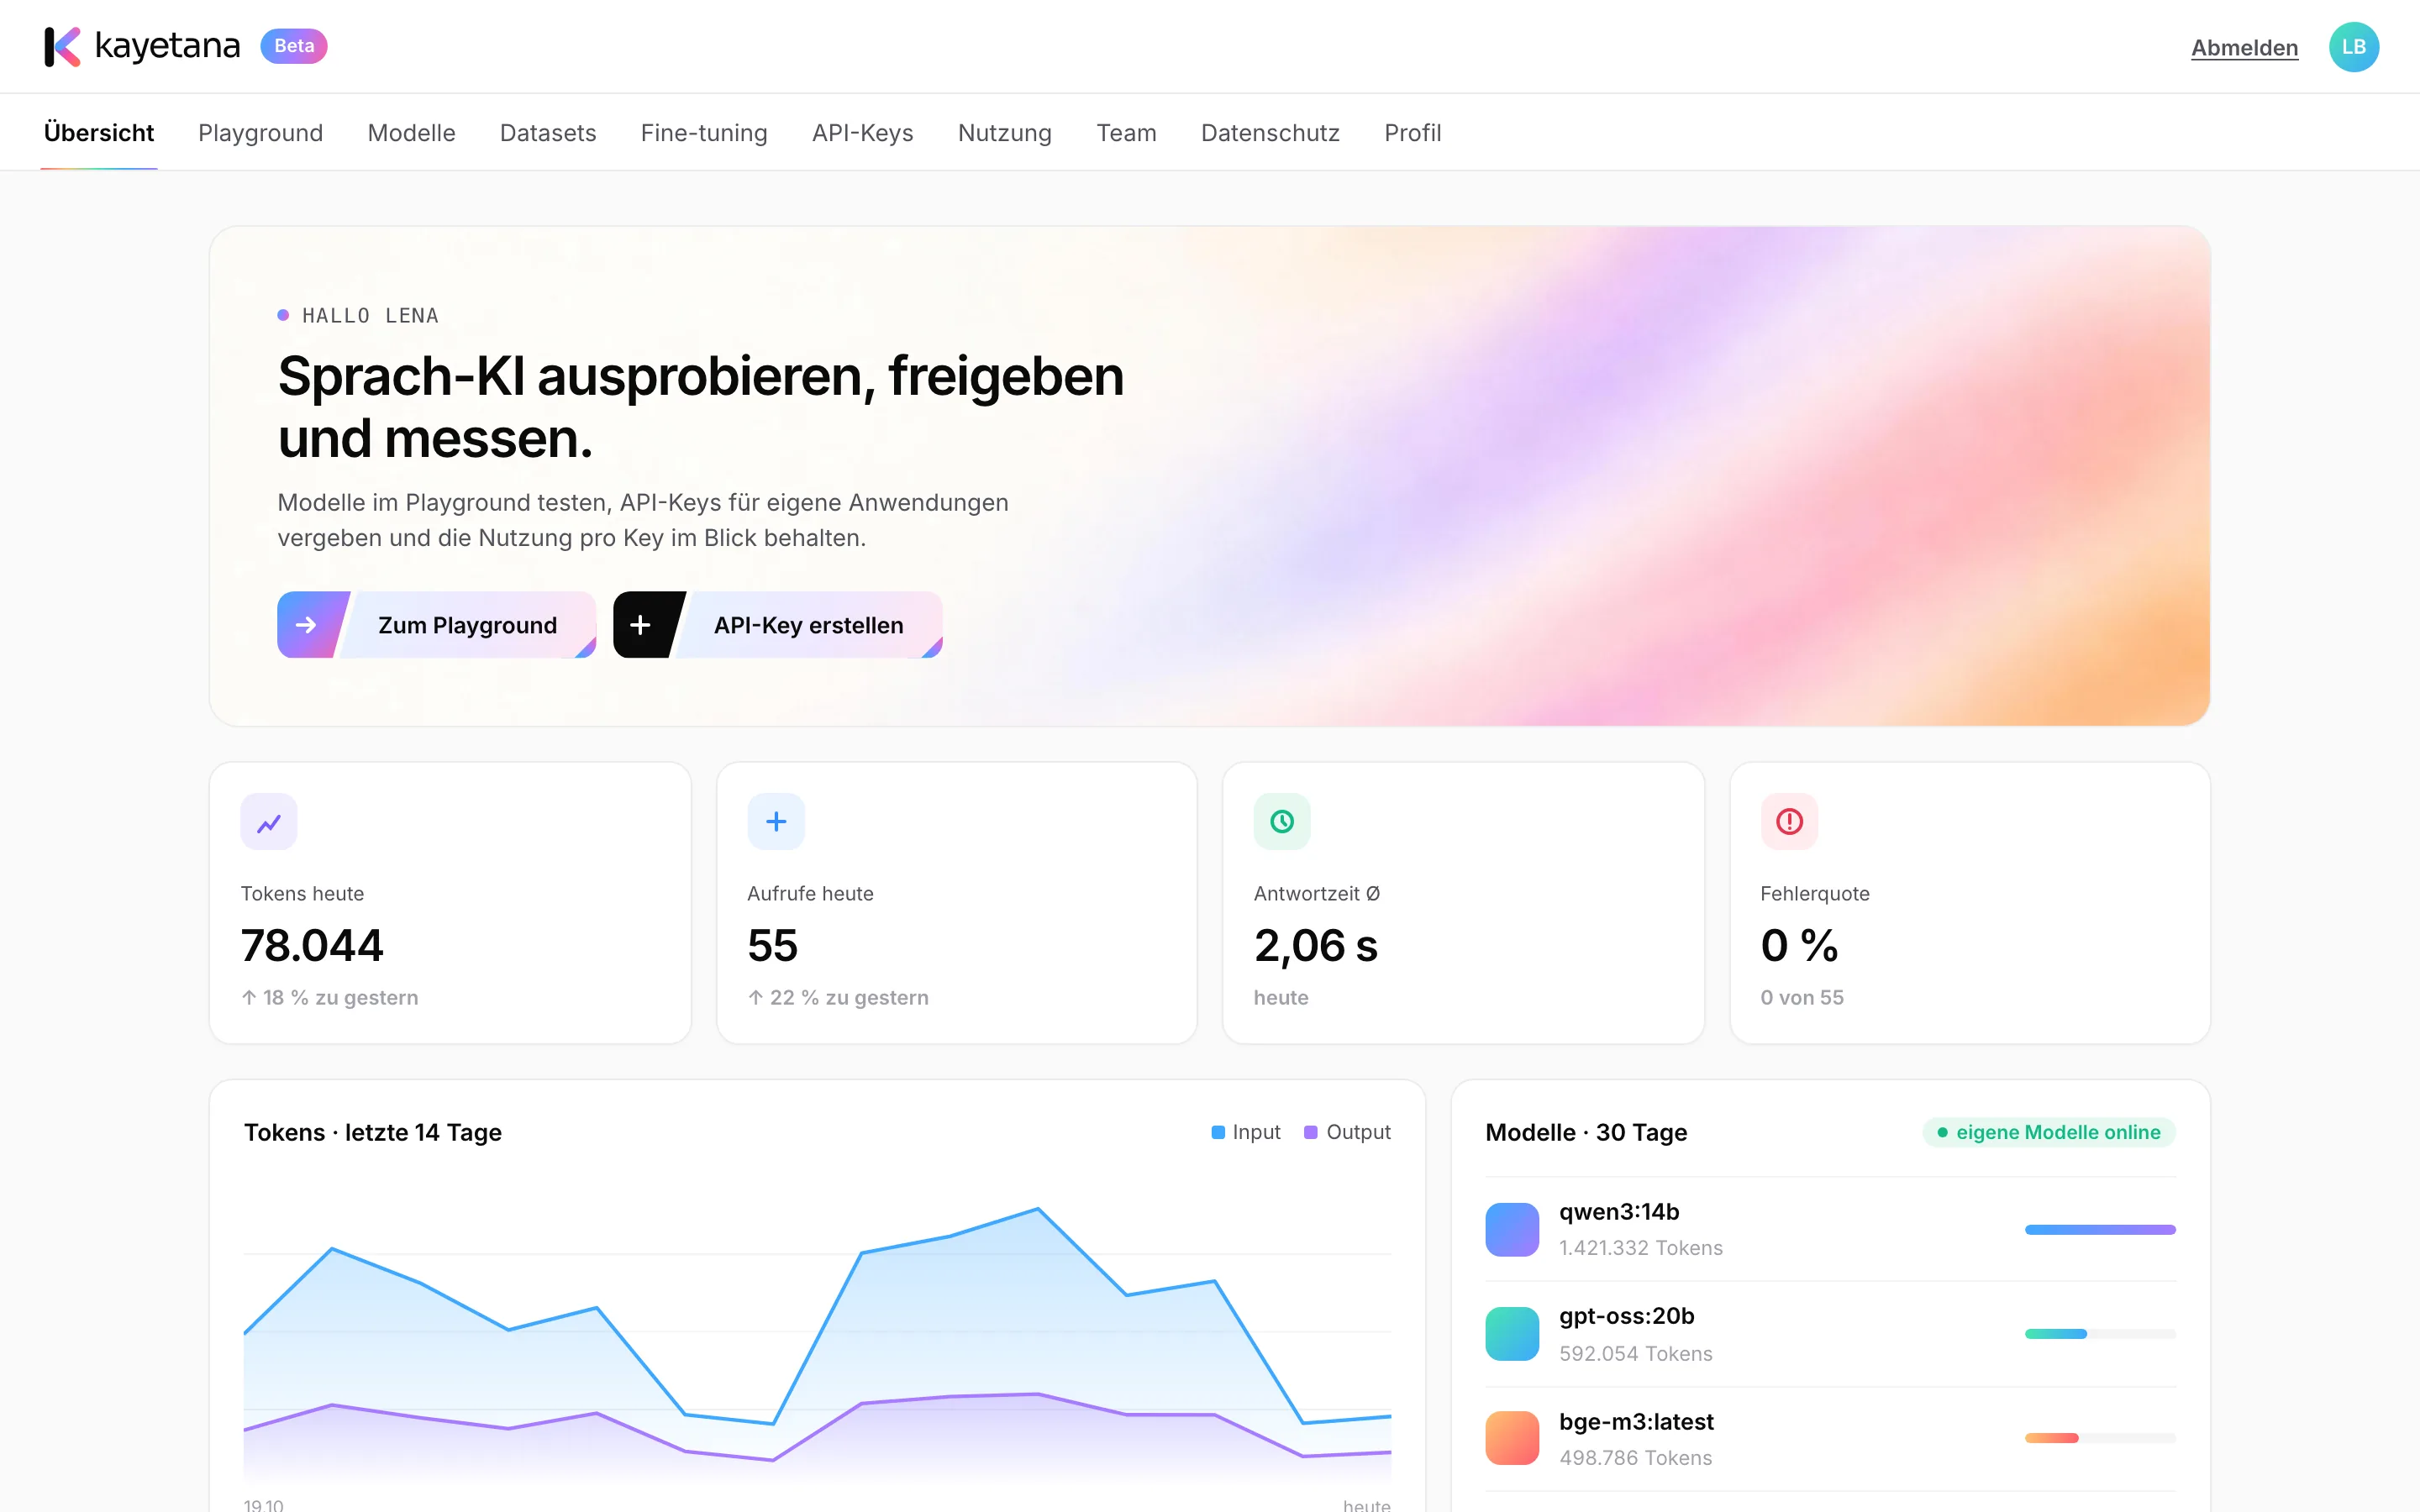
Die Nutzung zeigt Tokens, Aufrufe, Antwortzeit und Fehlerquote pro Key und Modell.
Was unter der Haube steckt.
- Läuft auf einem Mac Studio mit Apple-Chip
- Modelle über Ollama auf demselben Rechner
- Zusatzdienst für Transkription, Tokenizer, Dokumente und Fine-tuning
- Bedienung im Browser und per REST-API
- HTTPS mit eigenem Zertifikat im eigenen Netz
- Tägliches Backup um 3:15 Uhr, 14 Tage aufbewahrt
- Updates per Skript, Dienste starten nach Neustart selbst
- Pauschalpreis statt Abrechnung pro Token oder Nutzer
Sieh dir die Plattform mit deinen Beispielen an.
In einer Demo zeigen wir dir kayetana mit Fragen und Dokumenten aus deinem Alltag.
Häufige Fragen
Welche Hardware brauche ich?
Einen Mac Studio mit Apple-Chip. Wir empfehlen 36 GB Speicher oder mehr. Damit laufen Modelle bis etwa 20 Milliarden Parameter neben Suche und Transkription. Mit mehr Speicher gehen größere Modelle.
Brauche ich Internet?
Nur um Modelle und Updates zu laden. Danach läuft der Betrieb vollständig in deinem Netz.
Welche Modelle sind dabei?
qwen3:4b-instruct, qwen3:14b und gpt-oss:20b für Chat und Reasoning, bge-m3 für Suche, Rerank und Klassifikation und Whisper large-v3-turbo für Sprache. Alle sind offen lizenziert (Apache 2.0 bzw. MIT).
Kann ich kayetana an eigene Anwendungen anbinden?
Ja. Alle Funktionen sind über die REST-API erreichbar, mit API-Keys und einem Monatslimit je Key.
Was kostet kayetana?
Der Preis ist auf Anfrage. Du zahlst eine Pauschale für die Plattform, keine Abrechnung pro Token oder Nutzer.