 kayetana
Una plataforma para todo lo que tu equipo hace con IA.
kayetana funciona en un Mac Studio dentro de tu propia red. Pruebas modelos en el navegador, los abres a tus propias aplicaciones a través de la API y tienes el uso siempre bajo control. Los prompts y las respuestas nunca se guardan.
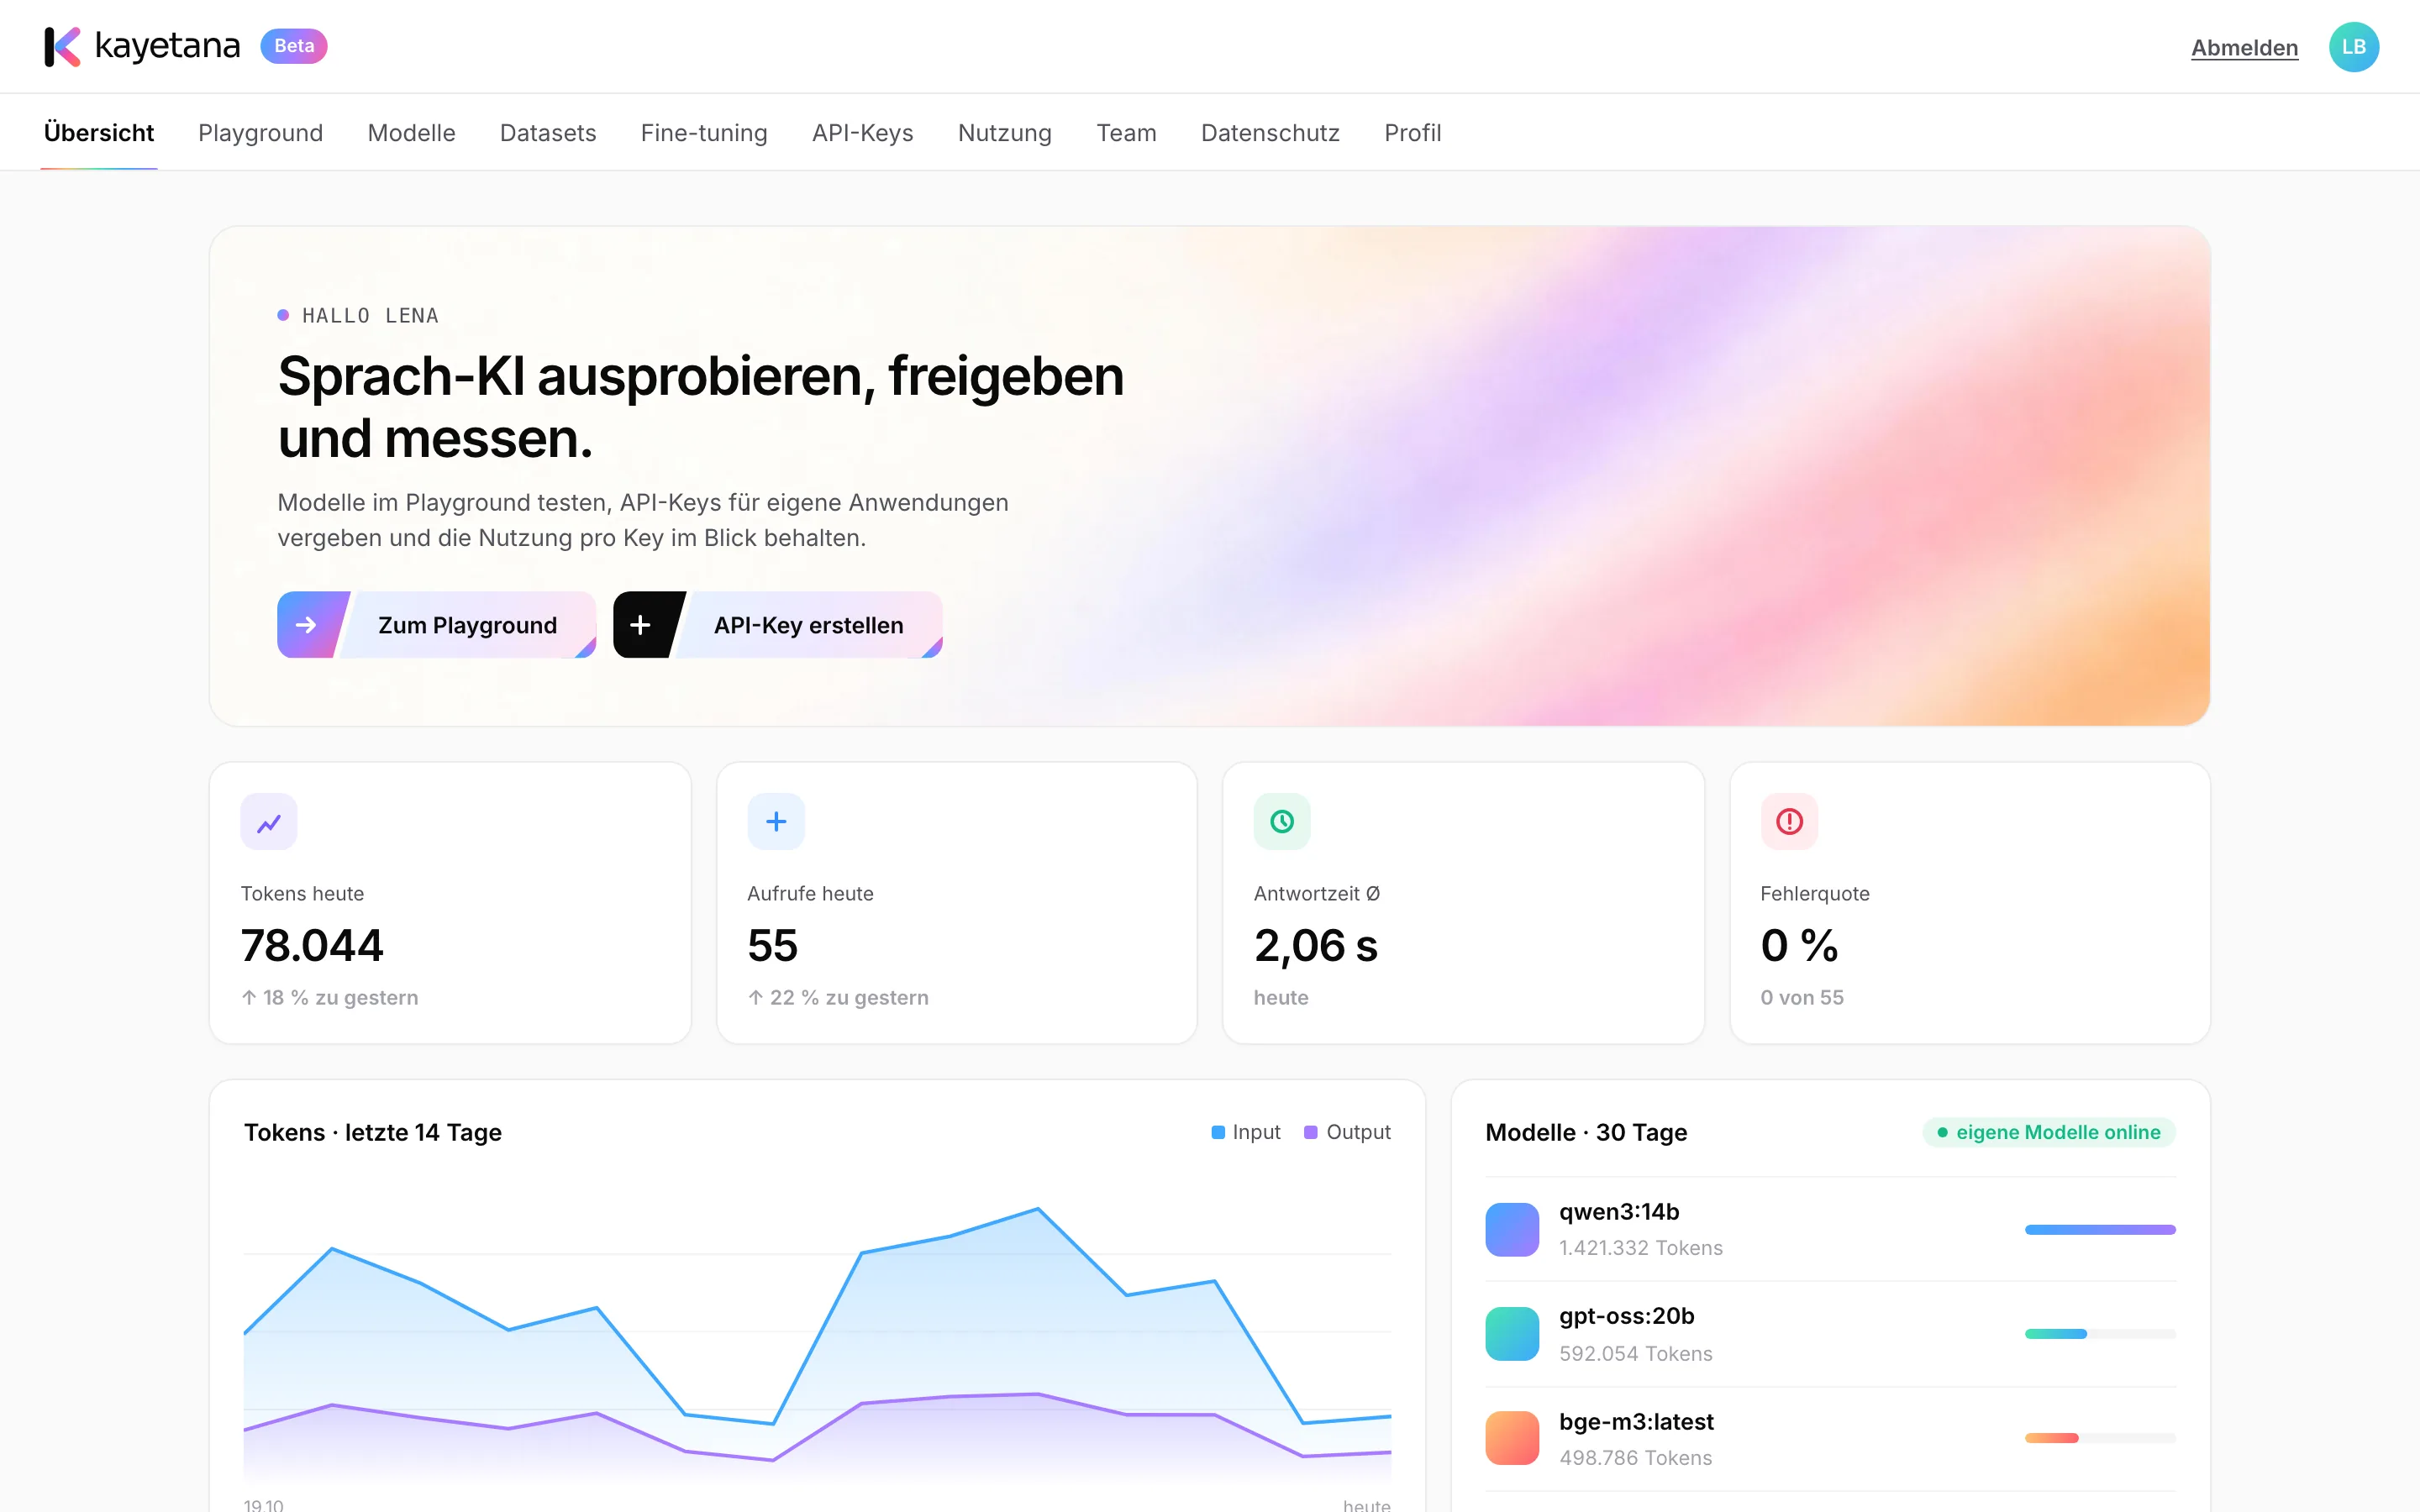
Prueba modelos en el navegador: instrucciones de sistema, razonamiento, JSON, imágenes, herramientas y código listo.
Más información →Respuestas a partir de documentosHaz preguntas sobre políticas, contratos y manuales. Cada afirmación muestra su fuente.
Más información →Búsqueda: embed y rerankConvierte texto en vectores y ordénalo por relevancia: la base de una búsqueda que entiende el significado.
Más información →ClasificarAsigna tickets y correos a categorías automáticamente, con ejemplos o con tu propio clasificador.
Más información →Audio y transcripciónConvierte reuniones y mensajes de voz en texto, con marcas de tiempo. Hasta 100 MB por archivo.
Más información →ModelosModelos abiertos para chat, razonamiento, búsqueda y voz. Añade otros nuevos y define uno predeterminado por tarea.
Más información →Fine-tuningEntrena un modelo de chat con tus propios ejemplos o crea tu propio clasificador.
Más información →Datasets y embed jobsSube archivos CSV, JSONL, TXT, PDF y Word y genera embeddings de colecciones enteras en segundo plano.
Más información →REST APITodas las funciones en una REST API, con claves de API, límites mensuales por clave y código de ejemplo listo.
Más información →Equipo y usoRoles de propietario, administrador y miembro, enlaces de invitación o inicio de sesión único, y una visión completa del uso.
Más información →Las herramientas que tu equipo usa cada día.
Todo funciona en tu propio servidor y puedes probarlo al instante en el navegador.
Chat y Playground
Prueba modelos directamente en el navegador, con instrucciones de sistema, razonamiento, modo JSON e imágenes.
Respuestas a partir de documentos
Sube políticas internas, contratos y manuales. Cada afirmación muestra de qué fuente procede.
Búsqueda con embed y rerank
Convierte texto en vectores y ordena los resultados por relevancia. La base de una búsqueda que entiende el significado.
Clasificar
Asigna automáticamente tickets de soporte y correos a categorías, con ejemplos o con un clasificador entrenado por ti.
Audio
Convierte reuniones y mensajes de voz en texto, con marcas de tiempo. Hasta 100 MB por archivo.
Modelos
Modelos abiertos para chat, razonamiento, búsqueda y voz. Añade otros nuevos y define tus modelos predeterminados.
Tus propios modelos, tus propias aplicaciones, reglas claras.
Fine-tuning
Entrena un modelo de chat con tus propios ejemplos de conversación o crea un clasificador a partir de datos etiquetados.
Datasets y embed jobs
Sube archivos CSV, JSONL, TXT, PDF y Word y genera embeddings de colecciones enteras en segundo plano.
REST API
Todas las funciones a través de una sola API, con claves de API y un límite mensual por clave.
Equipo y uso
Roles de propietario, administrador y miembro. Tokens y solicitudes por día, clave y modelo.
Seguridad y privacidad
Sin contenido almacenado, plazos de conservación propios, HTTPS en tu propia red.
Funciona sin conexión
Una vez descargados los modelos, el día a día no necesita internet.
Pruébalo antes de desarrollar nada.
El Playground reúne chat, embed, rerank, clasificación, tokens y audio. Ves al instante cómo responde un modelo a tu pregunta y copias exactamente esa configuración como código funcional en Python, TypeScript o curl.
- Guarda presets para todo el equipo
- Código funcional para cada solicitud
- Elige el modelo y la configuración para cada tarea
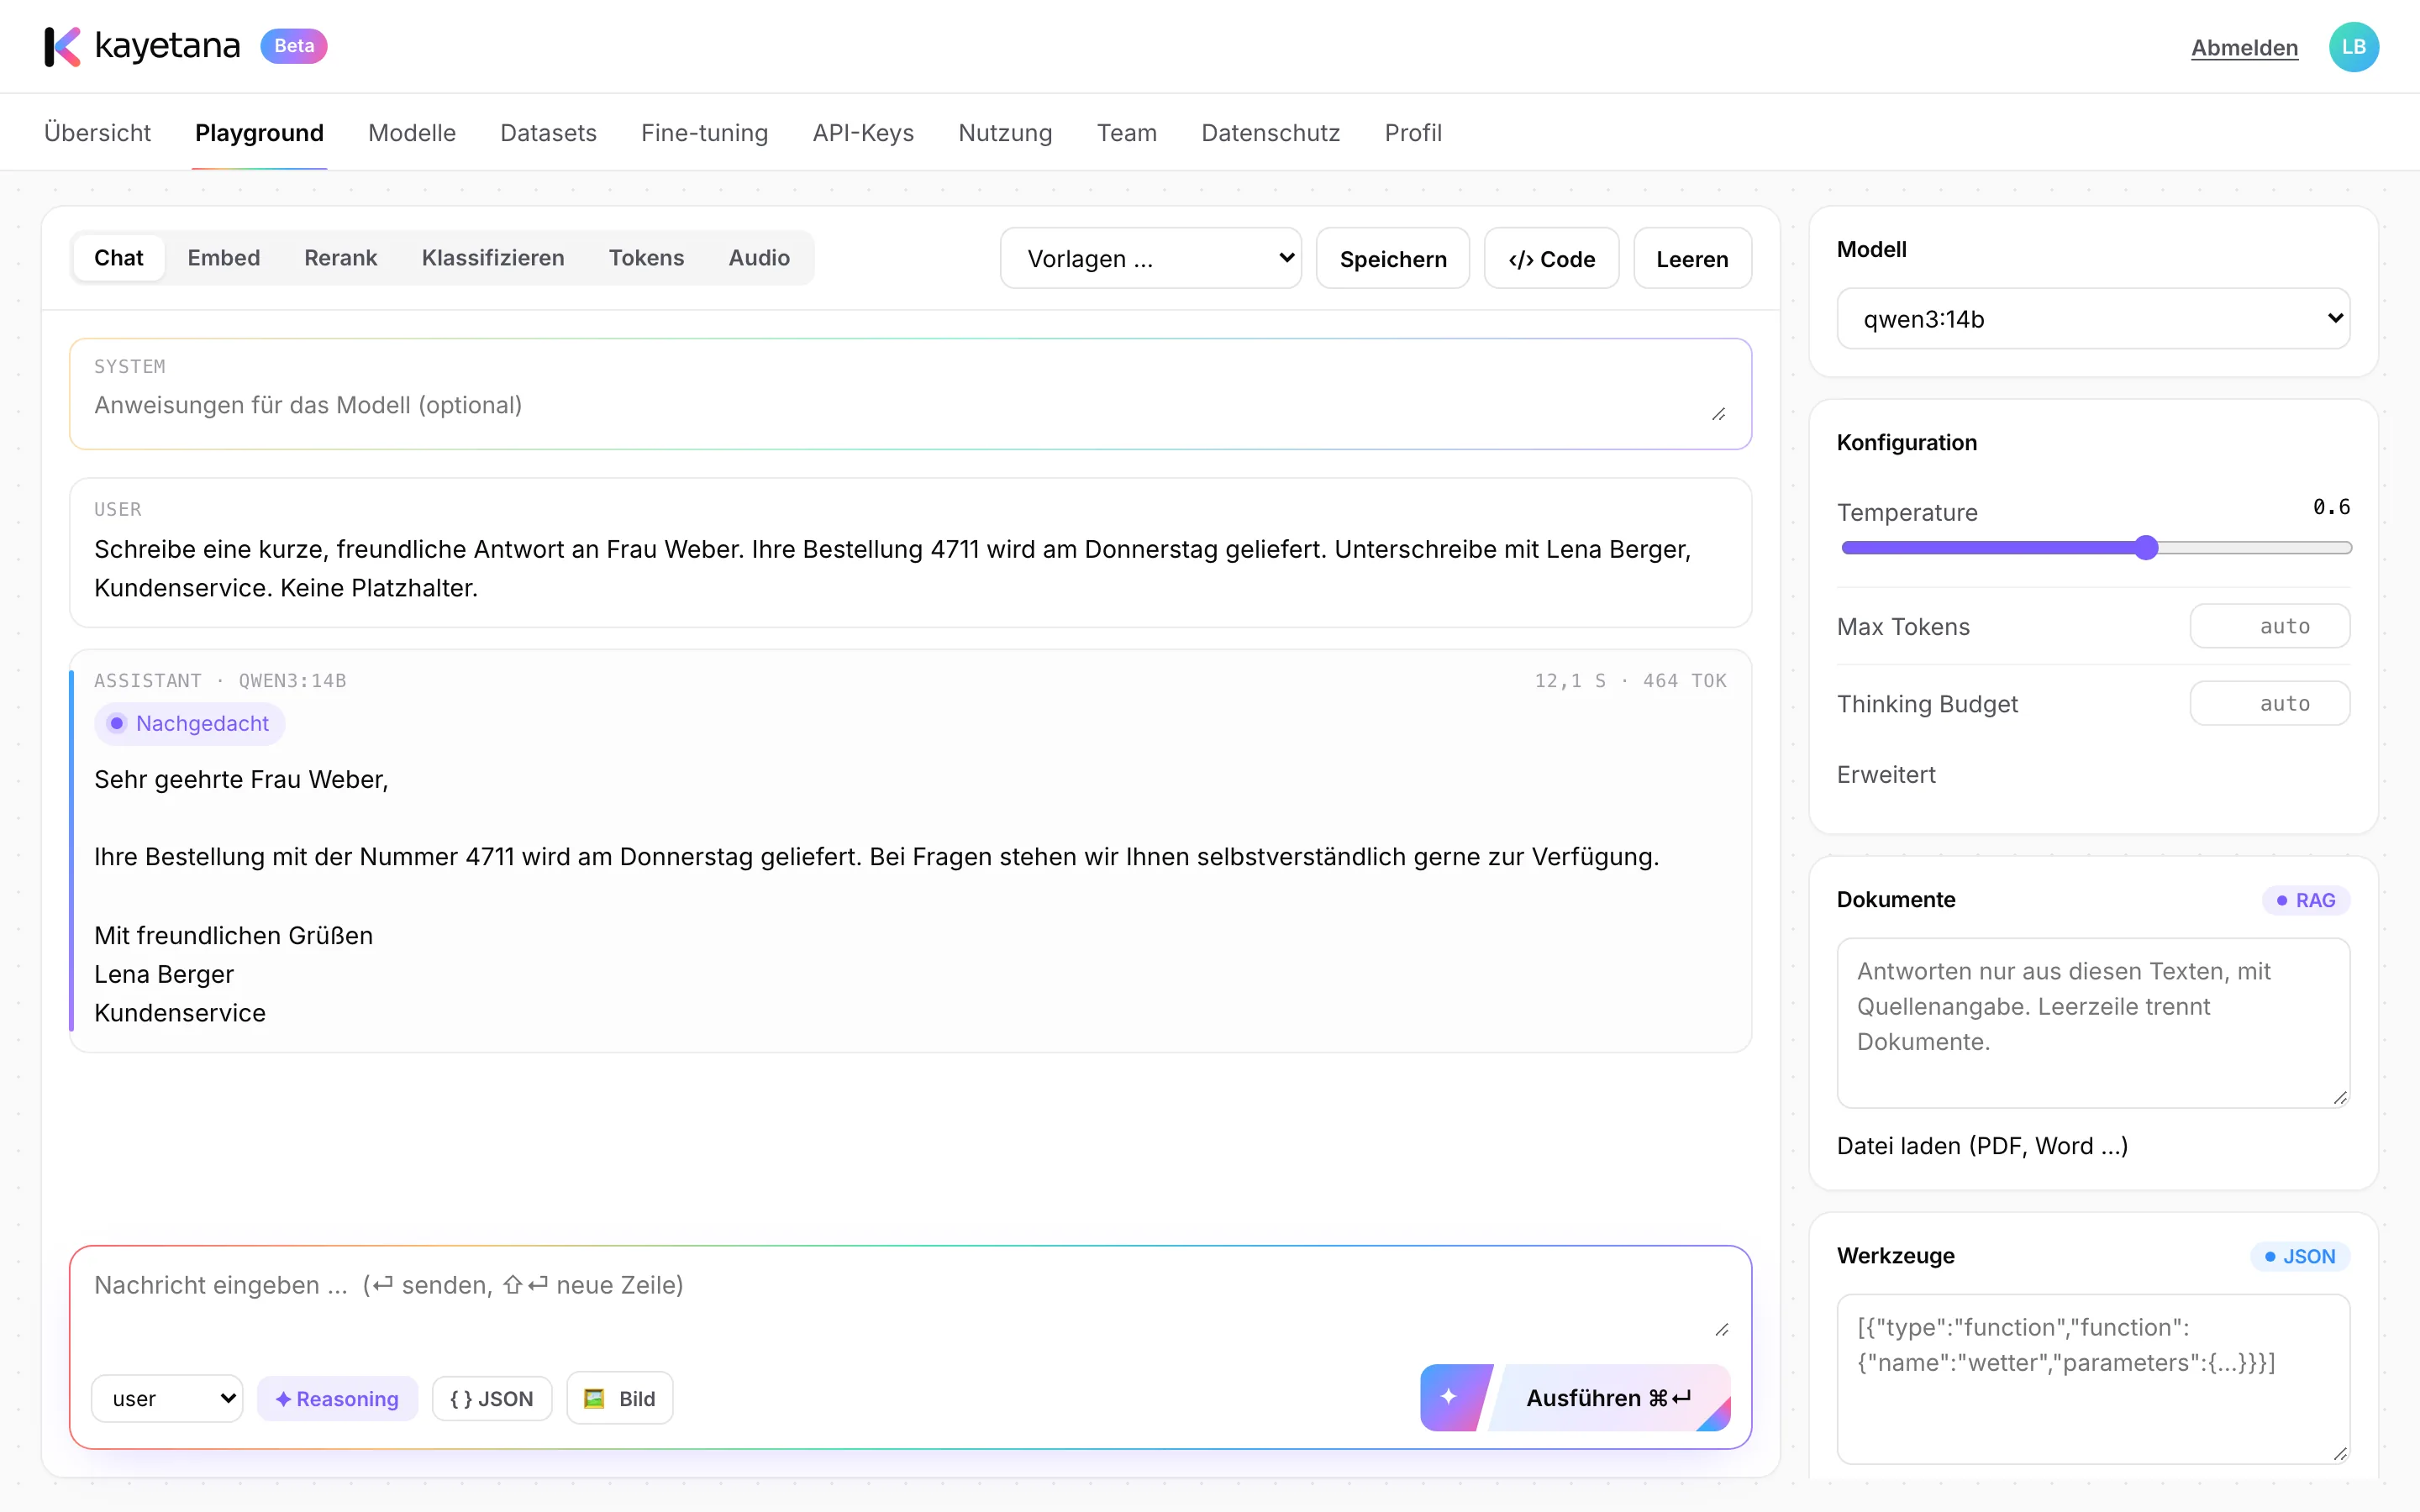
De una prueba rápida en el navegador a tu propia aplicación.
Probar
Prueba modelos en el Playground con ejemplos reales de tu trabajo, como una pregunta sobre tu política de viajes.
Compartir
Crea claves de API para tus aplicaciones, cada una con su propio límite mensual.
Adaptar
Usa datasets y fine-tuning para ajustar los modelos a tus tareas.
Controlar
El panel de uso muestra tokens, solicitudes, tiempo de respuesta y tasa de errores por clave y modelo.
Lo que lo hace funcionar.
- Funciona en un Mac Studio con Apple silicon
- Modelos servidos por Ollama en la misma máquina
- Servicio complementario para transcripción, tokenizador, lectura de documentos y fine-tuning
- Úsalo en el navegador o a través de la REST API
- HTTPS con tu propio certificado en tu propia red
- Copia de seguridad diaria a las 3:15, conservada 14 días
- Actualizaciones por script; los servicios se reinician solos tras un reinicio
- Tarifa plana en lugar de facturación por token o por usuario
Descubre la plataforma con tus propios ejemplos.
En una demo te mostramos kayetana con preguntas y documentos de tu propio trabajo.
Preguntas frecuentes
¿Qué hardware necesito?
Un Mac Studio con Apple silicon. Recomendamos 36 GB de memoria o más, lo que permite ejecutar modelos de hasta unos 20.000 millones de parámetros junto con la búsqueda y la transcripción. Con más memoria puedes usar modelos más grandes.
¿Necesito conexión a internet?
Solo para descargar modelos y actualizaciones. Después, todo funciona en tu propia red.
¿Qué modelos se incluyen?
qwen3:4b-instruct, qwen3:14b y gpt-oss:20b para chat y razonamiento, bge-m3 para búsqueda, reranking y clasificación, y Whisper large-v3-turbo para voz. Todos tienen licencia abierta (Apache 2.0 o MIT).
¿Puedo conectar kayetana a mis propias aplicaciones?
Sí. Todas las funciones están disponibles a través de la REST API, con claves de API y un límite mensual por clave.
¿Cuánto cuesta kayetana?
Precio bajo petición. Pagas una tarifa plana por la plataforma, sin facturación por token ni por usuario.